本文是 Systrace 系列文章的第七篇,主要是是介绍 Android 中的 Vsync 机制。文章会从 Systrace 的角度来看 Android 系统如何基于 Vsync 每一帧的展示。Vsync 是 Systrace 中一个非常关键的机制,虽然我们在操作手机的时候看不见,摸不着,但是在 Systrace 中我们可以看到,Android 系统在 Vsync 信号的指引下,有条不紊地进行者每一帧的渲染、合成操作,使我们可以享受稳定帧率的画面。
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些
本文目录
系列文章目录
- Systrace 简介
- Systrace 基础知识 - Systrace 预备知识
- Systrace 基础知识 - Why 60 fps ?
- Systrace 基础知识 - SystemServer 解读
- Systrace 基础知识 - SurfaceFlinger 解读
- Systrace 基础知识 - Input 解读
- Systrace 基础知识 - Vsync 解读
- Systrace 基础知识 - Vsync-App :基于 Choreographer 的渲染机制详解
- Systrace 基础知识 - MainThread 和 RenderThread 解读
- Systrace 基础知识 - Binder 和锁竞争解读
- Systrace 基础知识 - Triple Buffer 解读
- Systrace 基础知识 - CPU Info 解读
- Systrace 流畅性实战 1 :了解卡顿原理
- Systrace 流畅性实战 2 :案例分析: MIUI 桌面滑动卡顿分析
- Systrace 流畅性实战 3 :卡顿分析过程中的一些疑问
- Systrace 响应速度实战 1 :了解响应速度原理
- Systrace 响应速度实战 2 :响应速度实战分析-以启动速度为例
- Systrace 响应速度实战 3 :响应速度延伸知识
- Systrace 线程 CPU 运行状态分析技巧 - Runnable 篇
- Systrace 线程 CPU 运行状态分析技巧 - Running 篇
- Systrace 线程 CPU 运行状态分析技巧 - Sleep 和 Uninterruptible Sleep 篇
正文
版本说明(2026-10-13 核查):原文与截图来自 2019 年,完整设备版本未记录。DispSync、phase dump 和旧函数名按 AOSP
android-9.0.0_r1/android-10.0.0_r1理解;Android 16 的 Scheduler 已使用不同的预测与回调调度实现。文中的 60 Hz、0 / 4 ms Offset 是案例条件,不是所有设备的固定配置。
阅读新 Trace,可以配合 Perfetto 8:深入理解 Vsync 机制与性能分析,沿 App、RenderThread、SurfaceFlinger、GPU 和 Display/HWC 查同一帧。Android 12(API 31)起,采集到相应数据时可用 FrameTimeline 对照预期和实际时序;轨道缺失不代表耗时为零,也不能仅靠相邻片段认定帧归属。
硬件时序与软件调度是配合关系。 HWC 向 SurfaceFlinger 上报显示相关的 Vsync 时间戳;旧版 DispSync 据此建立周期模型,通过软件定时按不同相位触发 App/SF 回调。模型可在硬件回调暂时关闭时继续工作。因此“现在基本都由硬件产生”不能用来描述每一次 App 回调的来源。
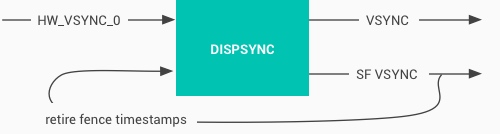
这张旧图中的 retire fence 是显示反馈,不是每个 App 的 GPU 渲染完成通知。不同年代的 retire/present fence 名称、语义和硬件偏差需要结合实现,不能把几个时间戳直接当同一个时刻。
在 Choreographer 渲染机制 中,App 按需请求下一次帧回调,再在 Looper 中执行 doFrame。没有更新任务时,不需要每个显示周期都重画。常见 60 / 90 / 120 Hz 间隔约为 16.67 / 11.11 / 8.33 ms;App 帧率、显示刷新率和回调频率不必完全相等。高刷背景可看 Perfetto 6:为什么是 120Hz?。
SurfaceFlinger 则按调度和图层状态处理事务、选择 Buffer 并组织合成,不是每次信号都把所有 Surface 无条件重画。下面是旧 Systrace 的相关轨道:
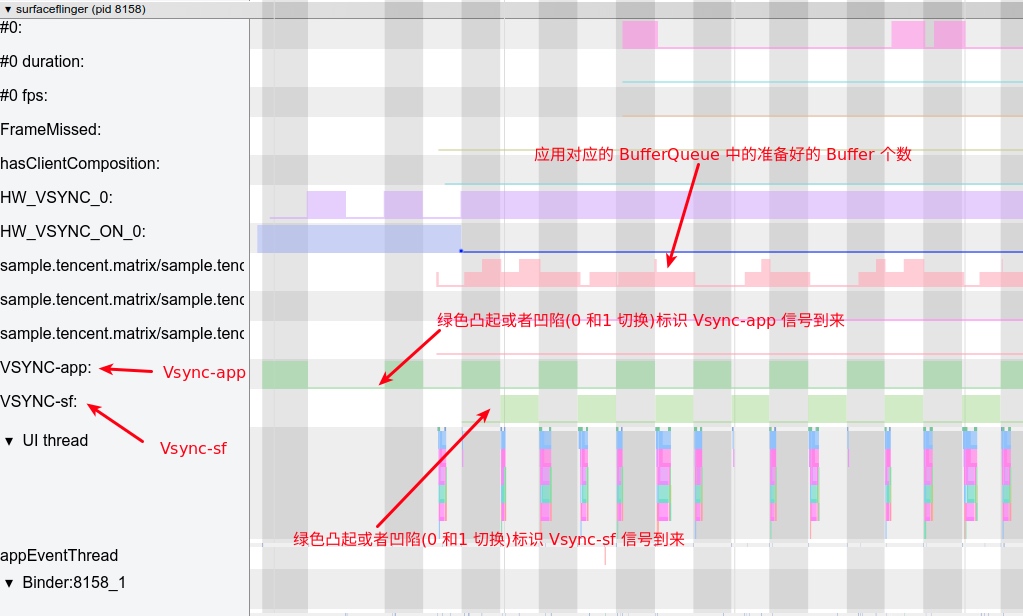
VSYNC-app、VSYNC-sf 的 0/1 每一次跳变用来标记事件,不是只有上升沿才算一帧,也不是高电平宽度等于工作耗时。软件回调、App 收到事件、线程实际获得 CPU 是不同时间;图层队列计数也不直接证明 GPU 已完成。
Android 图形数据流向
下面先用普通硬件加速 View 的旧 GL 路径说明数据如何到达屏幕。游戏、软件绘制和其他图形后端的函数名或步骤会不同。
- App 的
doFrame按需处理输入、动画和 Traversal,进行必要的 Measure、Layout、Draw。DisplayList 是绘制操作记录,不是原样保存的 OpenGL 命令列表。 - RenderThread 同步绘制状态并驱动图形后端,可能准备资源、编码和提交命令。
flush drawing commands不能简单解释为“把 CPU 数据上传 GPU”;共享内存也不免除缓存一致性、资源生命周期和同步要求。 - GPU 工作通常异步执行,CPU 线程可以继续,但在 Buffer、驱动队列或 fence 等位置仍可能等待。不能保证所有真机提交都立即返回、不阻塞。
- GL/EGL 路径通过
eglSwapBuffersWithDamageKHR等把 Buffer 及同步信息交给后续队列。queueBuffer/ swap 返回不等于 GPU 完成,更不等于已显示;Vulkan 路径也不必出现这些 EGL 函数名。 - SurfaceFlinger 根据图层状态和 HWC 协商结果安排 client/device composition。Client composition 可由 RenderEngine 使用 GPU;device composition 可使用显示硬件。Fence 约束何时能消费内容,等待可能由 GPU/显示硬件执行,不是每层都先由 SF 主线程阻塞等 GPU 再统一用 GPU 合成。旧
onMessageReceived/ invalidate / refresh 标记也不是新版通用接口。参见 Hardware Composer。 - 显示管线在合适的时刻呈现/扫描输出结果。一个 Buffer 提交、present fence 信号和屏幕所有像素完成更新不是同一个事件;不同硬件与合成方式也不要求先生成一张统一的“最终 Frame Buffer”。
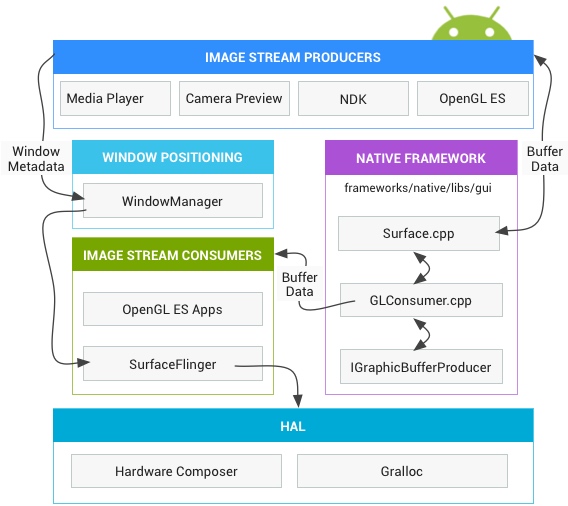
下面这张历史架构图同时画出了经过 SF GPU 合成和由显示控制器处理的路径,正好说明“合成全靠 GPU”并不准确。
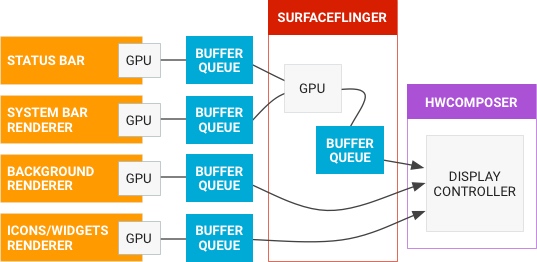
这些图适合认识生产者、Buffer、消费者和显示的关系,不代表 Android 16 的全部进程和队列布局,例如现代 View 路径还会涉及 BLASTBufferQueue。
Systrace 中的图像数据流
把上面的抽象流程放到这张旧 Trace 中,可以依次观察 App、SurfaceFlinger 和 composer 服务:
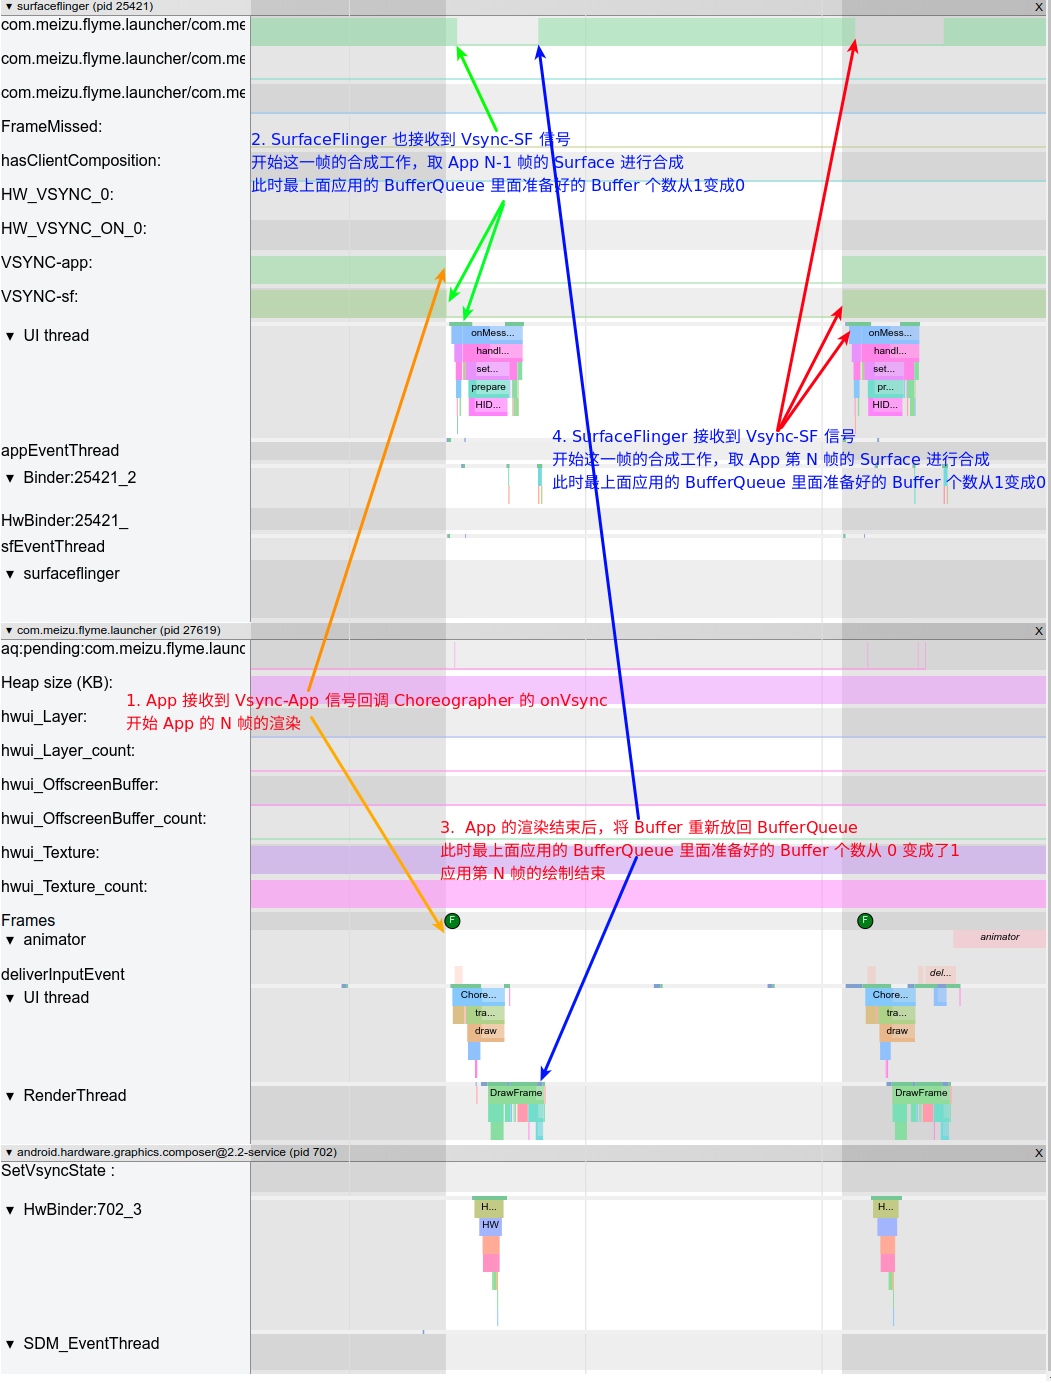
- 这次 App/SF 信号标记接近同相位;不意味着两个线程实际在同一纳秒运行。
- SF 处理当次合成时,选择的是之前已可用于该次合成的 Buffer。图中把它标作 App 的 N−1 帧。
- App 处理第 N 帧,经过主线程和 RenderThread 提交新的 Buffer,队列计数随之变化;图中的“渲染结束”只是提交过程的简写,GPU 完成还需另查。
- 后续 SF 调度处理第 N 帧,同时 App 可以准备下一帧。这里消费的是第 3 步提交的 Buffer,原文写成“第 2 步渲染”有误。
这是稳定流水线的一个样本。旧 Buffer 可以继续显示,新帧也可能被延迟、替换或丢弃;正式关联要用 Buffer/帧标识及 fence、FrameTimeline 等证据,不能把所有 Trace 都机械套成 N−1 / N。
Vsync Offset
旧 DispSync 使用硬件时间戳和显示反馈维护模型,再按 App/SF 相位安排软件回调,基本关系如下:

phase-app、phase-sf 都是相对参考显示时序的偏移。在下面的简图中,App 较早开始,SF 在稍后的相位处理工作。
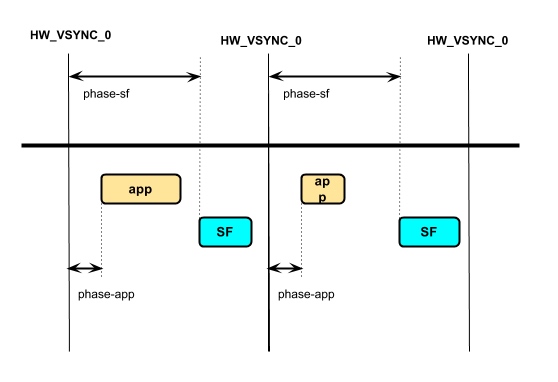
本文为了比较,把 Δ = phase-sf − phase-app 称为两者的 Offset;它不等于完整的 Vsync 配置。相位可以为负、跨越周期,系统还可能切换 early/late 等配置,不能统一限制为 0–16.6 ms。也没有证据说明“大部分厂商都设为 0”。相位相同只是计划时序相同,不保证线程同时收到消息或获得 CPU。
可用 adb shell dumpsys SurfaceFlinger 查看设备实际 dump,但字段随版本变化。下面保留两份历史输出,不把它们当成 Android 16 固定格式。
两相位之差为 0:App 与 SF 都是 1,000,000 ns,即各自相对参考时序偏移 1 ms,并不是两者自身的 phase 都为 0。
1 | Sync configuration: [using: EGL_ANDROID_native_fence_sync EGL_KHR_wait_sync] |
两相位之差为 4 ms:6,000,000 − 2,000,000 = 4,000,000 ns。这里 16,666,666 ns 的周期约对应 60 Hz。
1 | Sync configuration: [using: EGL_ANDROID_native_fence_sync EGL_KHR_wait_sync] |
present offset 是另一项显示反馈/时序配置,不是上面两相位之差。early、early GL 等行也是候选配置,不能从静态 dump 断定某帧实际采用哪一行。
Offset 为 0
先看这次相位差为 0 的案例:
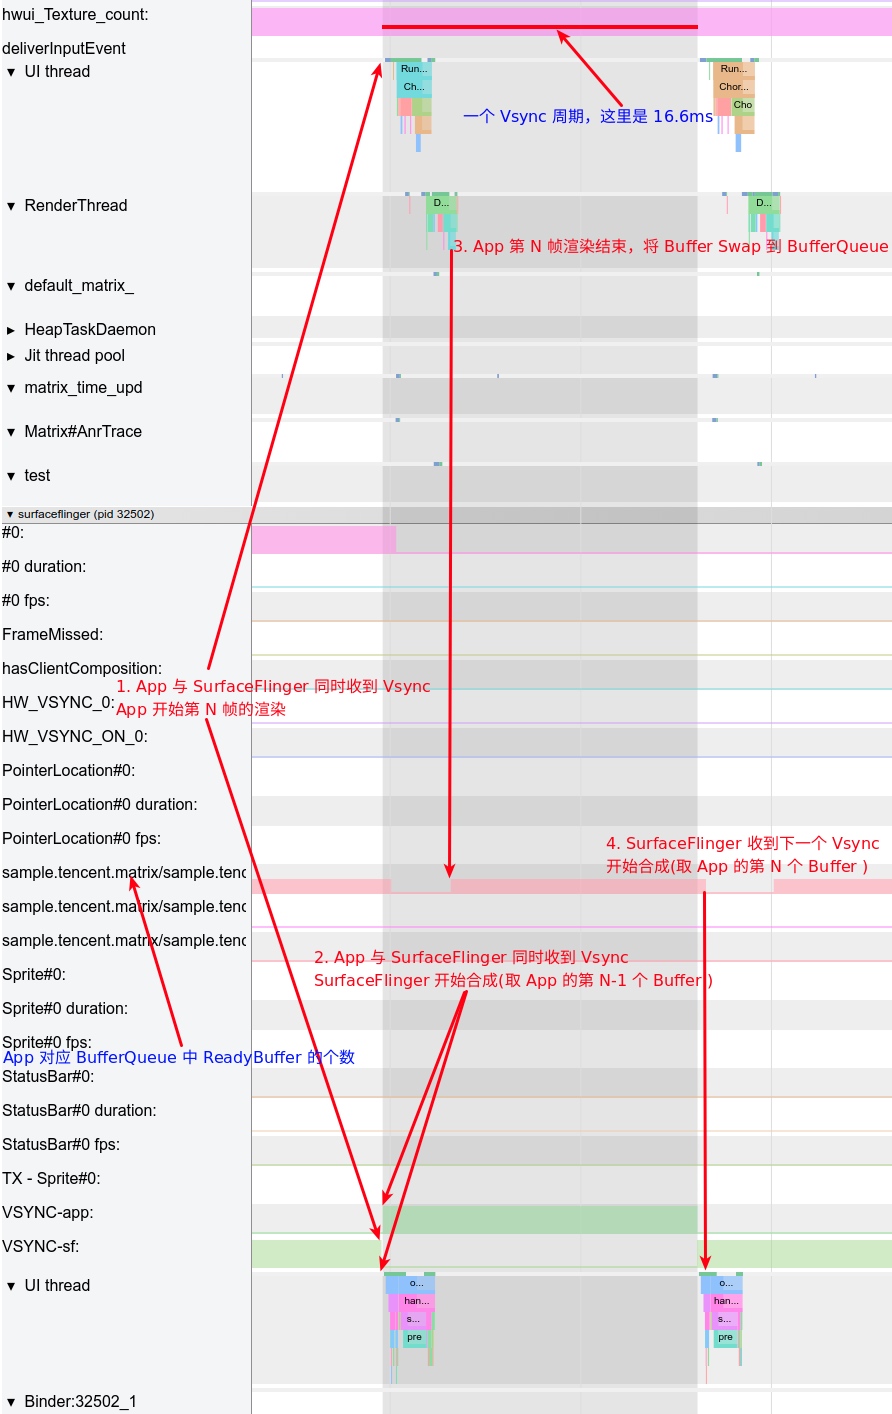
App 和 SF 的计划回调接近对齐,App 新提交的 Buffer 在下一次 SF 工作中被使用。图上约 16.6 ms 标的是两个 Vsync 之间的周期;从 Buffer 提交到被取用的等待,只是这个周期剩余的一部分,不能一律写成又等了完整 16.6 ms。
看到这里,大家可能会想:App 的 Buffer 已经准备好了,能不能让 SurfaceFlinger 早点拿去合成,少等一会儿?把 SF 的计划相位稍后安排,有机会让 App 在当次 SF 工作前提交可用的新帧。但这不是“queueBuffer 一完成就立即触发 SF 合成”的事件模式;仍要满足当次 latch/合成条件,并给 GPU、SF/HWC 留出目标显示时刻之前的时间。
Offset 不为 0
下面保留原文标作 4 ms 的相位差案例:
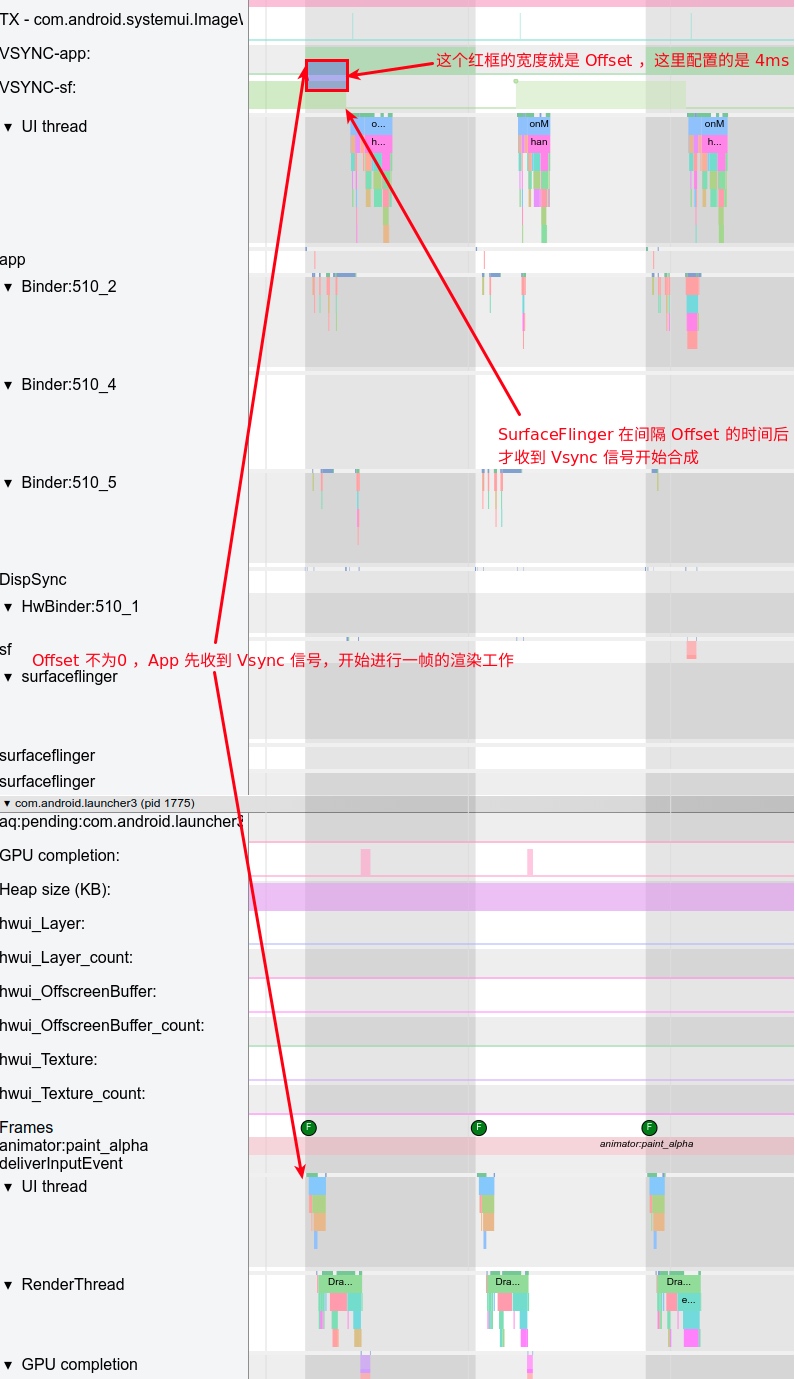
红框说明的是两个调度标记的间隔,不是 App 渲染耗时、GPU 完成时间或触摸到显示的总延迟。是否更早呈现,还要沿着这一帧的提交、同步和显示结果核实。
Offset 的优缺点
调整相位是在输入新鲜度、App 工作时间和合成余量之间取舍,不能仅凭“越大/越小越好”配置。
- Δ 太小,App 的新 Buffer 可能赶不上本次合成。旧内容通常仍可继续显示,不是该 App 从画面里消失。理想化的周期模型里,下一次 SF 时刻相对 App 开始可能是 T + Δ,但它不是完整的端到端显示延迟公式。
- Δ 太大,可能挤压 SF/HWC 及相关 GPU 工作的时间,导致错过目标显示时刻;也可能在某个负载下仍有收益,并非简单“失效”。
Android 16 补充:Scheduler 配合 VSyncPredictor、VSyncReactor 和 VSyncDispatchTimerQueue 等组件预测并安排回调。后者会按目标 Vsync、workDuration、readyDuration 计算唤醒时间,并处理调度更新;不能直接拿旧 DispSync 的常量或一组固定 phase 解释所有帧。参见 VSyncDispatchTimerQueue.cpp(android-16.0.0_r1)。
另外,Android 15 引入的 ARR 还需要显示硬件与 HAL 支持。ARR 可将显示 Vsync 节奏与实际刷新间隔解耦,例如官方案例用约 240 Hz 的 Vsync 步长支持最高 120 Hz 的刷新;不能看到某个 Vsync 周期就直接当作 App 帧率。见 Adaptive refresh rate。
HW_Vsync
关闭 HWC 的 Vsync 事件回调,不等于关闭面板刷新,也不意味着 GPU 停止工作。软件预测可以在不持续接收硬件回调时继续安排 App/SF 事件;重同步或显示模式变化等情况再请求硬件样本。
原文的 500 ms 需要改正。下面是 Android 9 SurfaceFlinger 中的完整方法:
1 | void SurfaceFlinger::resyncWithRateLimit() { |
它比较的是这次调用与上次调用这个限流方法之间的时间,且每次都会更新 sLastResyncAttempted;不是“距离上次合成超过 500 ms”。这也不是开启硬件回调的唯一入口。Android 10 Scheduler 有类似 500 ms 条件,而 Android 16 Scheduler::resync() 的对应限流值为 750 ms,均不能当作公开 API 保证。
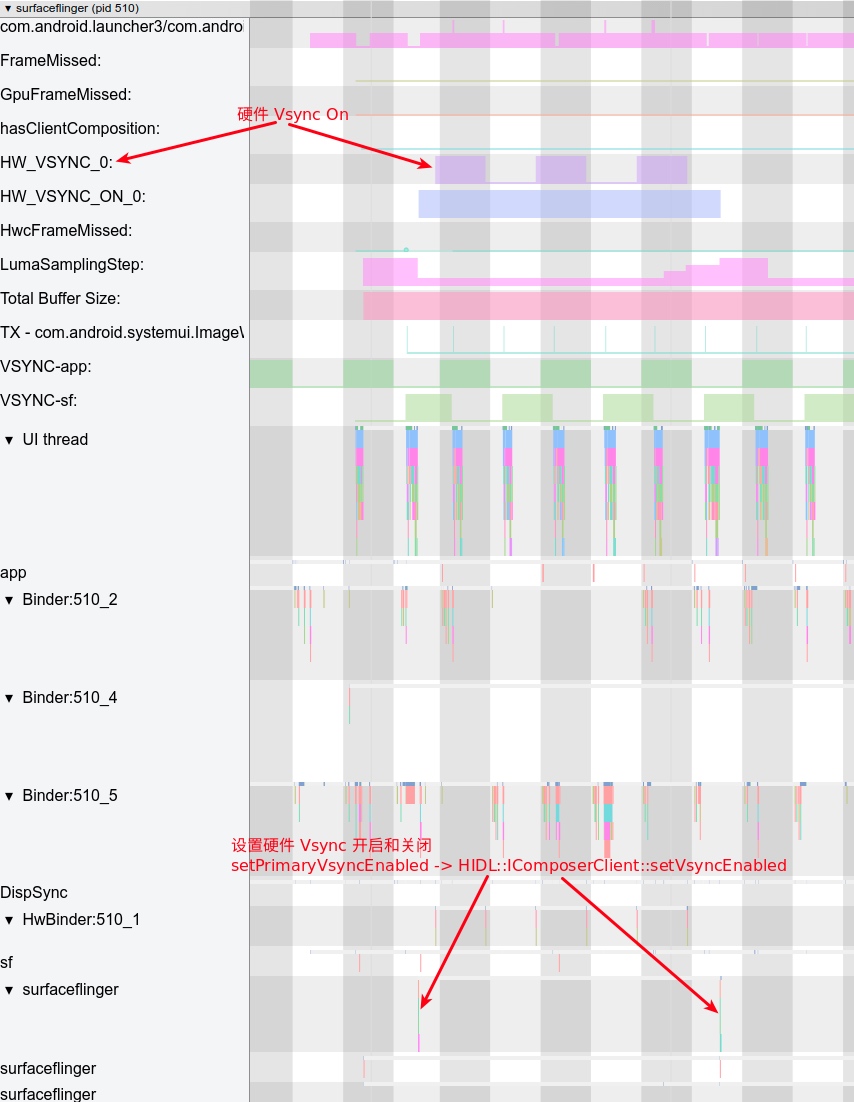
图中 HW_VSYNC_0 的跳变与 HW_VSYNC_ON_0 的使能区间要区分;后者不是面板开关。轨道没有跳变也可能与回调关闭或采集内容有关,不能直接判定显示停止。
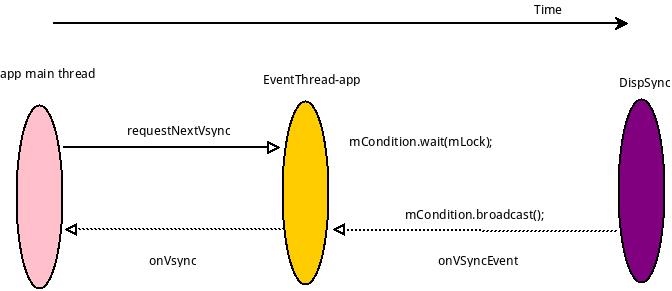
不使用HW_VSYNC
这张旧图表示已建立的软件模型继续分发事件,不需要每次 App 请求都等待一个新的 HWC 回调。
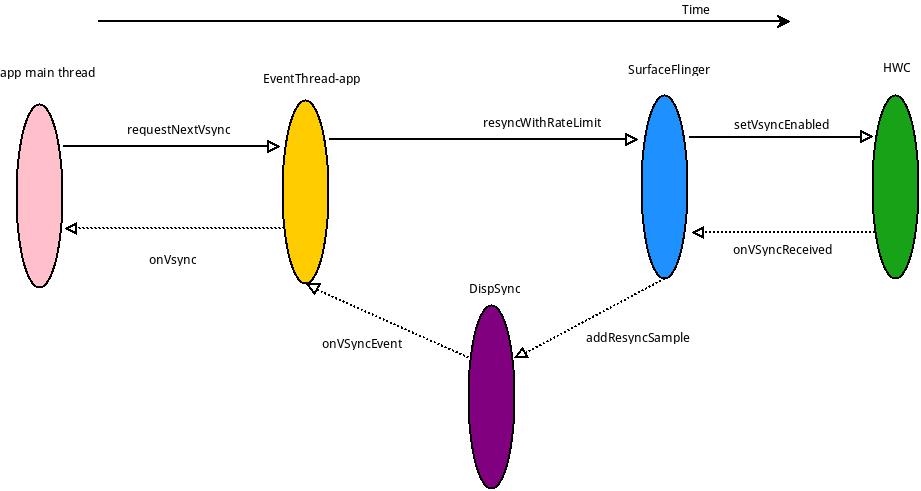
使用 HW_VSYNC
这张图增加了请求重同步、接收硬件时间戳并更新模型的路径。图中直连 App 的箭头是简化表示:旧 EventThread 通过 Connection / BitTube 分发显示事件,App 的 native 接收与 Looper/Choreographer 再处理,并不是服务端直接调用 Java onVsync。
关于样本数量,以 Android 9 DispSync.h 和 DispSync.cpp 为准:
- 重同步时间戳最多保留 32 个,
updateModelLocked()在至少 6 个时重新估计模型。6 个时间戳形成 5 个间隔,去掉最大、最小间隔后还剩 3 个参与周期平均;不能写成“最低只需 3 个硬件 Vsync”。 mPeriod是周期,mPhase才是模型相位,还要结合参考时间和每个 listener 的 phase。初始化会先设置显示周期,首个重同步样本也会更新参考,因此不是必须等 6 个样本后才可能产生任何软件回调。- 误差来自有效 present fence 时间戳与模型的比较,
mError是均方误差,单位为 ns²;该版本阈值160000000000表示(400 µs)²。重新采样是否继续还结合模型有效性及半阈值回差;忽略 present fence 时走另一分支。没有有效样本、或源码中误差被重置为 0,也不等于实测零误差。
这些是特定版本的算法细节,不是 Android 永久不变的“6/32”规则。Android 16 的 VSyncPredictor 使用自己的样本参数与预测逻辑,应对照对应版本。原 SW-VSYNC 的生成与传递 可作旧版流程补充阅读。
本文其他地址
本站的后续同主题文章:Perfetto 8:深入理解 Vsync 机制与性能分析。
参考
- VSYNC
- https://juejin.im/post/5b6948086fb9a04fb87771fb
- http://gityuan.com/2017/02/05/graphic_arch/
- SW-VSYNC 的生成与传递
- http://echuang54.blogspot.com/2015/01/dispsync.html
关于我 && 博客
下面是个人的介绍和相关的链接,期望与同行的各位多多交流,三人行,则必有我师!
- 博主个人介绍 :里面有个人的微信和微信群链接。
- 本博客内容导航 :个人博客内容的一个导航。
- 个人整理和搜集的优秀博客文章 - Android 性能优化必知必会 :欢迎大家自荐和推荐 (微信私聊即可)
- Android性能优化知识星球:付费社群已于 2026 年停止运营,不再招收新成员;此处保留历史介绍。
一个人可以走的更快 , 一群人可以走的更远