本文介绍了 App 开发者不经常接触到但在 Android Framework 渲染链路中非常重要的一个类 Choreographer,包括 Choreographer 的引入背景、简介、部分源码解析、与 MessageQueue 的交互、在 APM 中的应用,以及手机厂商基于 Choreographer 的一些优化思路。
Choreographer 将待执行的帧回调与显示时序协调起来,而不是自行调整屏幕刷新率。以 120 Hz 为例,刷新间隔约 8.33 ms;是否能按时交付帧还取决于 CPU 调度、GPU、Buffer 和合成管线。应用按需请求回调,不是每个物理 Vsync 都要重新绘制。本文也会区分 FrameCallback、FrameMetrics、gfxinfo、Looper 和 Perfetto 各自能观察到的范围。
版本说明(2026-10 核查):历史 MethodTrace/Systrace 图与本文 Perfetto 图保留原貌,缺少原始 trace 时只按可见内容解释。旧代码骨架以 android-10.0.0_r1 为参照;涉及 VsyncEventData、FrameInfo 和新版回调的节选按 android-16.0.0_r1 标注,BLAST 路径另用 Android 15 源码。节选省略了外围字段、校验和分支,不是可直接编译的应用代码,也不再把混合片段称为某日 mainline HEAD 的完整实现。
本文目录
- Perfetto 系列目录
- 主线程运行机制的本质
- Choreographer 简介
- 源码解析
- MessageQueue 与 Choreographer
- APM 与 Choreographer
- 厂商优化
- 参考资料
- 本文知乎地址
- 关于我 && 博客
本文是 Perfetto 系列文章的第五篇,主要是对 Perfetto 中的 Choreographer 进行简单介绍
本系列的目的是通过 Perfetto 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Perfetto 这个图形化的角度,你可以理解的更深入一些。
Perfetto 系列目录
- Android Perfetto 系列目录
- Android Perfetto 系列 1:Perfetto 工具简介
- Android Perfetto 系列 2:Perfetto Trace 抓取
- Android Perfetto 系列 3:熟悉 Perfetto View
- Android Perfetto 系列 4:使用命令行在本地打开超大 Trace
- Android Perfetto 系列 5:Android App 基于 Choreographer 的渲染流程
- Android Perfetto 系列 6:为什么是 120Hz?高刷新率的优势与挑战
- Android Perfetto 系列 7:MainThread 和 RenderThread 解读
- Android Perfetto 系列 8:深入理解 Vsync 机制与性能分析
- Android Perfetto 系列 9:CPU 信息解读
- Android Perfetto 系列 10:Binder 调度与锁竞争
- Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测
- Android Perfetto 系列 12:Trace 数据流与丢失排查
- Android Perfetto 系列 13:Perfetto SDK、Track Event 与 App 现场 Trace
- Android Perfetto 系列 14:heapprofd 与内存 Profiling
- Android Perfetto 系列 15:Boot Trace、长时间现场 Trace 与偶发问题抓取
- Android Perfetto 系列 16:GPU、Power Counters 与硬件瓶颈分析
- Android Perfetto 系列 17:专项场景自动化、问题清单与平台体系
- Android Perfetto 系列 18:响应速度实战,从输入事件到首帧反馈
- 视频(B站) - Android Perfetto 基础和案例分享
- 视频(B站) - Android Perfetto 分享 - 出图类型分享:AOSP、WebView、Flutter + OEM 系统优化分享
如果大家还没看过 Systrace 系列,下面是传送门:
- Systrace 系列目录 : 系统介绍了 Perfetto 的前身 Systrace 的使用,并通过 Systrace 来学习和了解 Android 性能优化和 Android 系统运行的基本规则。
- 本文的 Systrace 版本:Android 基于 Choreographer 的渲染机制详解
- 个人博客 :个人博客,主要是 Android 相关的内容,也放了一些生活和工作相关的内容。
欢迎大家在 关于我 页面查看交流方式,讨论你的问题、你最想看到的关于 Perfetto 的部分,以及跟各位群友讨论所有 Android 开发相关的内容
主线程运行机制的本质
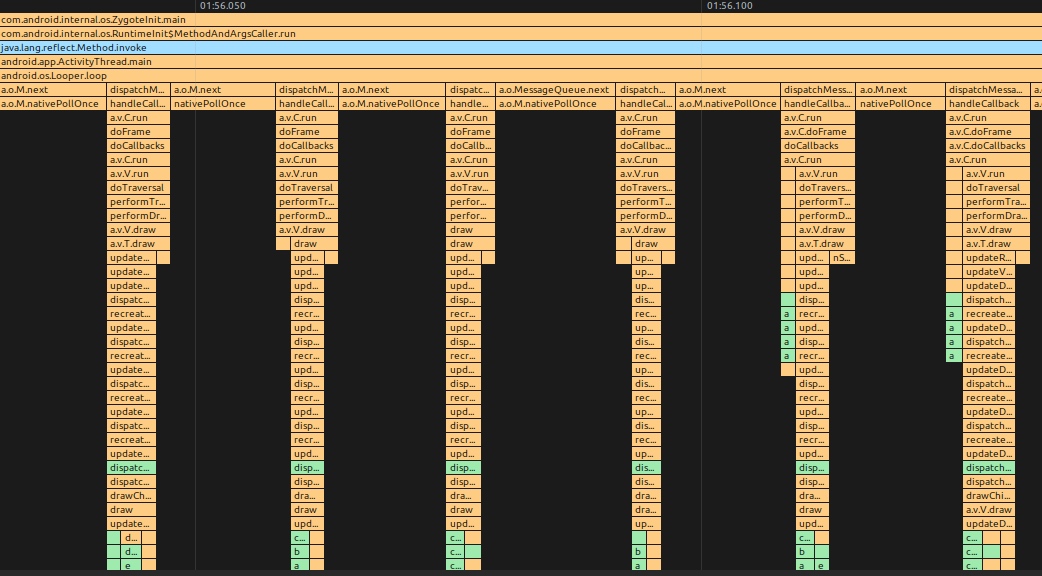
主线程的很多 Java 工作经由 Looper 分发 Handler 消息;MessageQueue 负责排队/取消息,不直接执行业务。nativePollOnce 还会处理文件描述符事件,Vsync 接收就是其中一条路径,因此不能说主线程的一切工作都是一条 Java Message。下图展示该样例的等待和消息分发。
MethodTrace
Perfetto

演进
原文用下面两张图说明引入 Vsync 之前的连续渲染,但图中已经出现 Choreographer.doFrame 和 RenderThread。它们只能作为某种配置下连续工作的历史样例,不能证明来自 Choreographer 引入前的 Android。
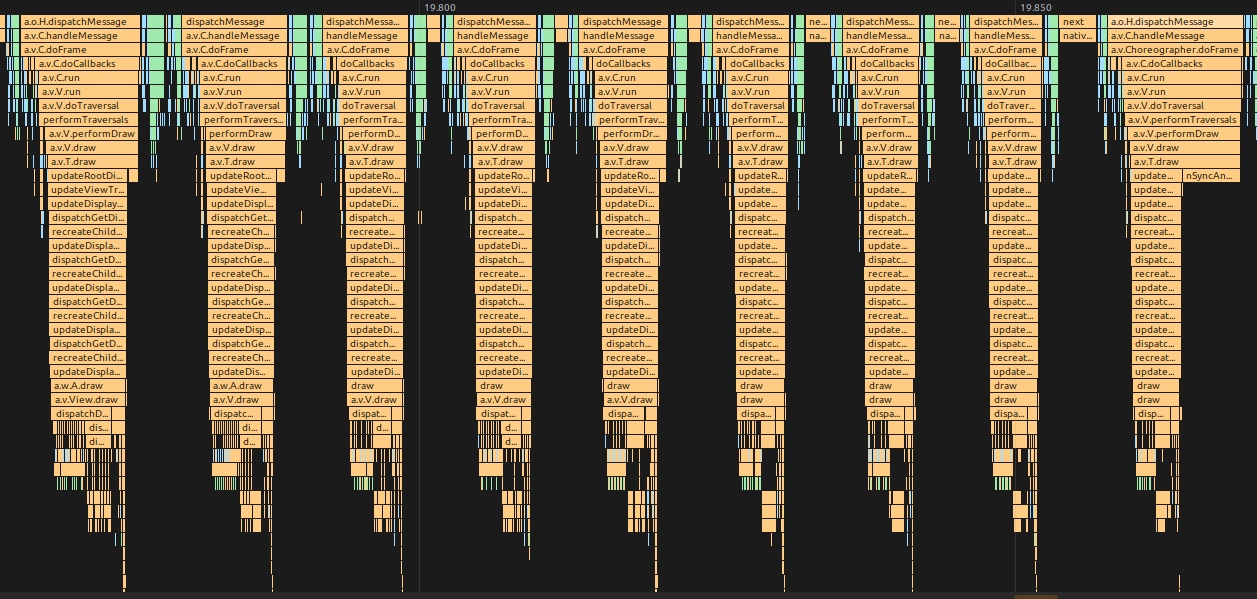
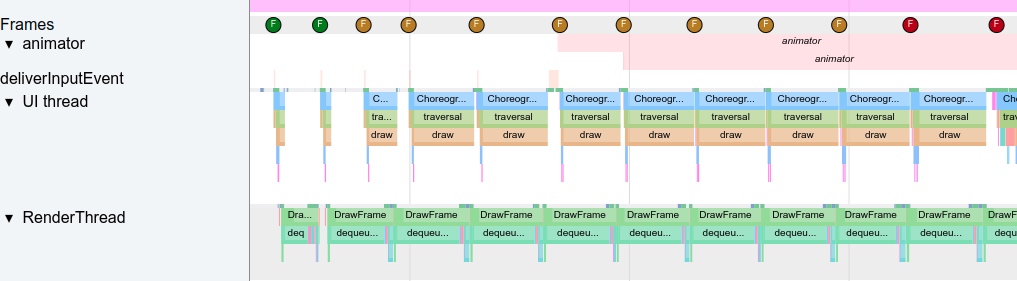
dequeueBuffer 等待可能与可用 buffer、consumer 释放或 fence 有关,不能仅凭截图假定 SurfaceFlinger 以固定速度消费所有 App Buffer。传统 framebuffer 的表述也不能直接套用所有现代显示管线。
Choreographer 自 API 16 提供。Vsync 节拍和缓冲有助于组织渲染,但不保证帧率稳定;后续 BLAST 改变 buffer/transaction 提交路径,具体见下文。
对于用户来说,稳定的帧率才是好的体验,比如你玩王者荣耀,相比 fps 在 60 和 40 之间频繁变化,用户感觉更好的是稳定在 50 fps 的情况.
这是对体验的直观描述;实际平滑度还取决于呈现间隔。固定 60 Hz 屏幕无法用整数个刷新周期均匀呈现 50 fps,不能据此给所有设备的帧率波动作统一排名。
引入 Choreographer
Choreographer 为动画和遍历等到期回调提供与显示时序相关的执行机会。收到一次软件 Vsync 通知后,还要等待所属 Looper 的调度;它不是显示硬件中断直接执行 Java 绘制。
下图是旧的 60 Hz 简图,16.6 ms 不能作为所有设备的端到端预算。图中 RenderThread 标作 GPU 并不准确:它是 CPU 线程,负责组织并提交绘制工作,GPU 异步执行;UI、RenderThread、GPU 与 SurfaceFlinger 的阶段也可能重叠。
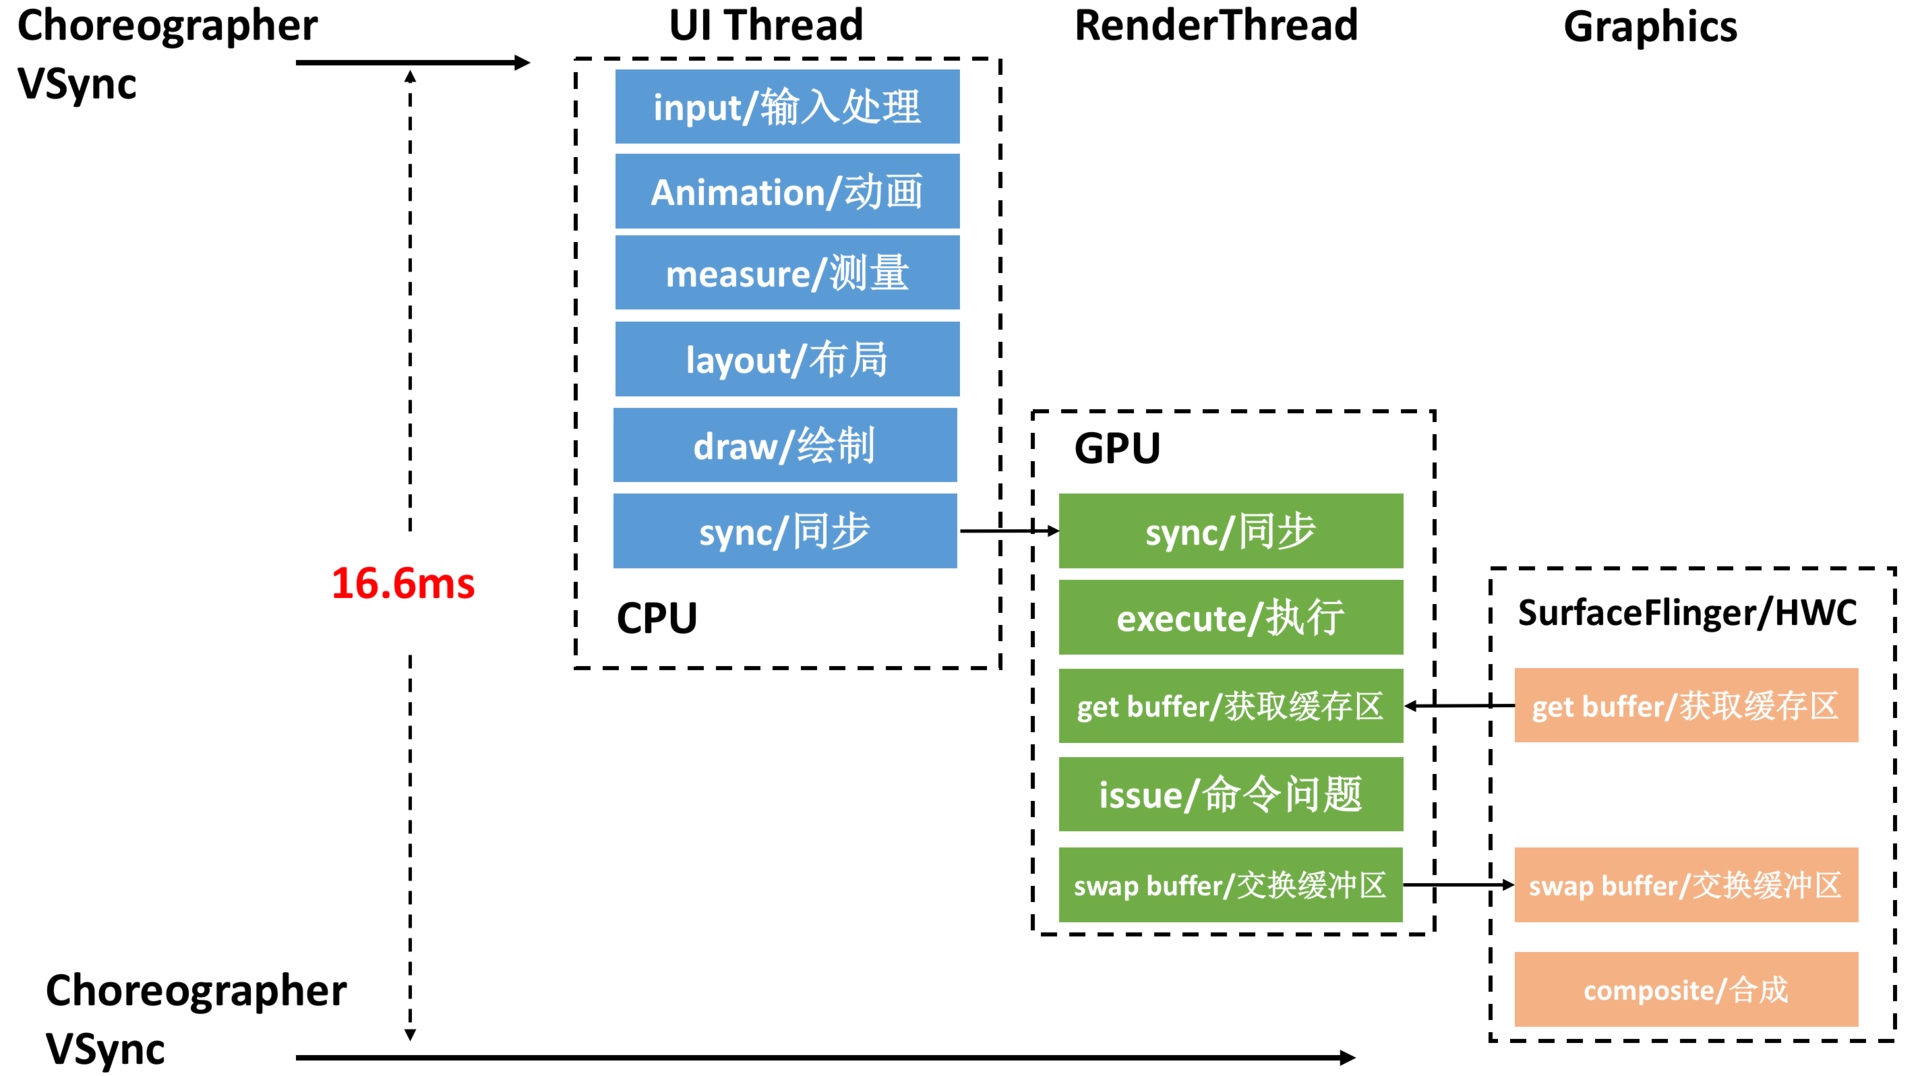
120 Hz 的相邻刷新间隔约 8.33 ms,实际工作期限还受流水线调度影响。刷新率与帧率的区别可结合90 Hz 文章阅读。
Choreographer 简介
Choreographer 协调注册到它的帧回调,不接管所有 Handler 消息。框架按 Input、Animation、Insets Animation、Traversal、Commit 的顺序处理已到期回调;这些是执行阶段,不是 Linux 线程优先级。
它通过 DisplayEventReceiver 请求/接收软件 Vsync 时序。应用、RenderThread、GPU 和 SurfaceFlinger 是否及时完成,仍需分别观测,不能从“使用了 Choreographer + BLAST”推出稳定 60/90/120 fps。APM 接口的观测范围见后文。
流程图有助于解释机制,这篇我主要用 Perfetto 和 MethodTrace 来讲。把 CPU、SurfaceFlinger、SystemServer 和 App 的活动放在同一条时间线上,再对照代码,比较容易看清它们怎样配合。下面会引用少量示意图,其余尽量跟着 Trace 走;具体能看到哪些活动,仍要看采集内容。
从 Perfetto 的角度来看 Choreographer 的工作流程
下面是设置界面滑动的历史 Perfetto 截图。绿色 Running 状态是 CPU 调度状态,不是已经呈现的一帧;长方形 slice 也可能包含等待。
- 图中
VSYNC-app用计数器翻转标示软件 Vsync 节奏,作者标注约 8.33 ms。高/低电平不是“Vsync 正在执行”的持续时间,不能把整段方波周期误作单次刷新间隔;具体含义需对应采集端。 - 可沿 doFrame、DrawFrame、Buffer 提交与 SurfaceFlinger 轨道看依赖,但不同线程/帧会重叠,UI 与 RenderThread 的墙钟耗时不能直接相加作为最终帧时长。
- BLAST 可将 buffer 与 transaction 提交给 SurfaceFlinger;提交不代表 GPU 已完成,也不证明已上屏,要看 fence、合成和呈现信息。

有了整体图,再放大主线程的一帧,看看 Choreographer 在哪里、怎么组织这些回调。图里的箭头用来定位工作链路。原标注“queueBuffer(即 GPU 开始工作)”不成立:GPU 提交/执行与 queueBuffer 没有这种固定一一对应关系。也不能把主线程 slice 的右边缘当作最终呈现时刻。

Choreographer 的工作流程
getInstance()在有 Looper 的线程上取得默认线程局部实例,初始化 Handler、DisplayEventReceiver 和回调队列。- 有到期工作时按需请求 Vsync;文件描述符事件到达后,经 JNI 回调
onVsync(),再投递异步 Message。 - Message 被 Looper 分发时,
run()调用doFrame(),处理帧时间、到期回调和诊断标记。 - 顺序执行 Input → Animation → Insets Animation → Traversal → Commit。Traversal 可能进行 measure/layout/draw,与 RenderThread 同步;不是每帧都重做所有步骤。
- RenderThread/GPU 绘制、BLAST 提交及 SurfaceFlinger 合成可与这些工作交叠。Commit 不是 GPU 完成或上屏回调。
- 动画/滚动等仍有工作时重新注册下一次帧回调,才形成连续过程;单次 FrameCallback 不会自动永久循环。
下面的旧 MethodTrace 可帮助找对应调用,不代表各版本有相同参数或每帧有全部阶段。
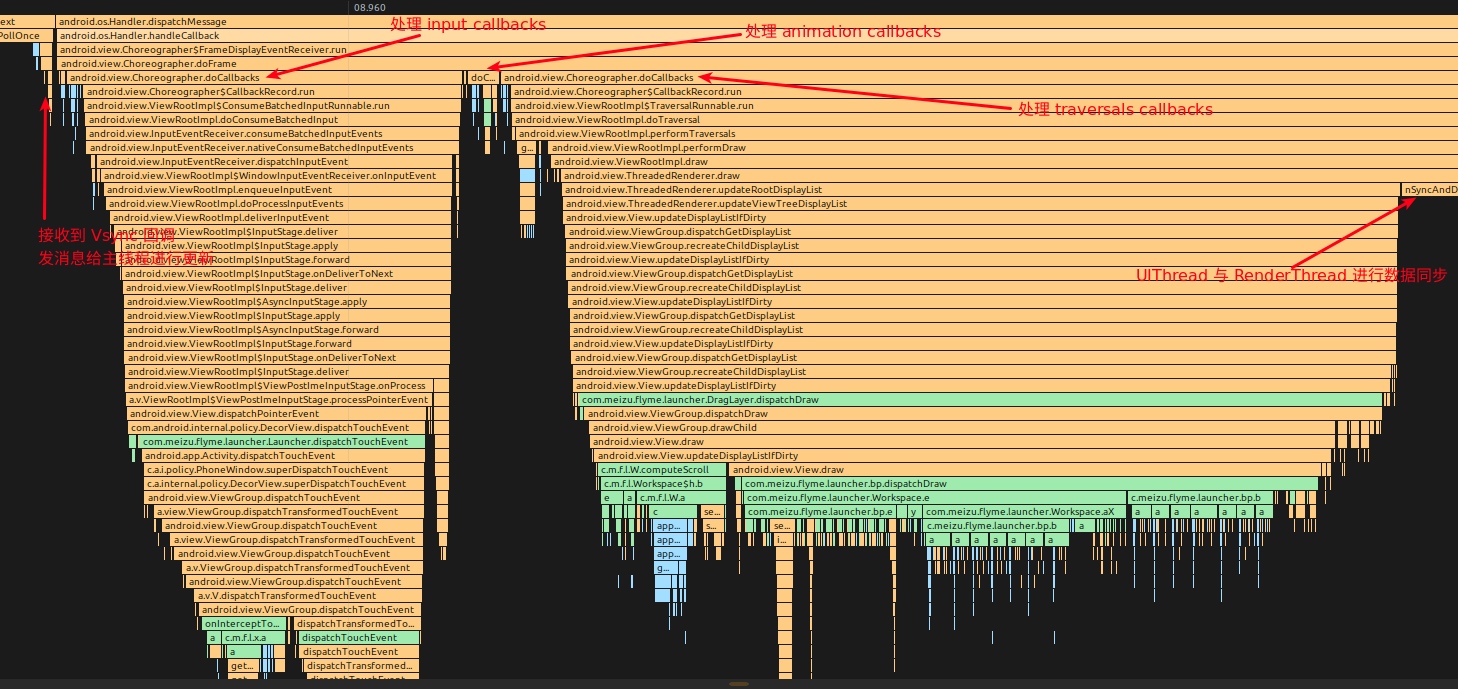
Choreographer 与 RenderThread 及 BlastBufferQueue 的交互
下面以 Android 15 的常见 ViewRootImpl 窗口路径说明 BLAST,不能把这一条路径当作所有 Android 版本、Surface 类型或厂商固件的统一实现。
BlastBufferQueue 工作原理
Android 15 BLASTBufferQueue 在客户端维护 BufferQueue 的生产者和消费者,并将获得的 buffer 放入 SurfaceControl transaction。它改变了与 SurfaceFlinger 协调 buffer/窗口事务的方式,没有消除可用 buffer、fence 或背压等待。
ViewRootImpl 会创建并更新 BLASTBufferQueue;SurfaceControl 变化也可能销毁重建。下面只保留原文的创建骨架,不是完整 relayout 条件:
1 | // 创建 BBQ 的示例代码 |
主线程与 RenderThread 的同步还受 HWUI DrawFrameTask、资源上传和队列中已有任务影响。不能只因为使用了 BLAST 就断言主线程一定更早返回或阻塞概率下降;需要同场景 trace/测量,相关等待案例见ANR 第三篇。
源码解析
以下保持“调用关系与关键片段”的写法,旧注册/动画/遍历骨架以 Android 10 Choreographer 为参照;构造、FrameHandler、VsyncEventData 和 doFrame 标记/阶段示例按 Android 16 更新并分别说明。省略字段/校验/局部变量的骨架不能拼起来作为可编译类。Native 注册另按 Android 10 解释。
Choreographer 的初始化
Choreographer 的单例初始化
1 | // Thread local storage for the choreographer. |
Choreographer 的构造函数
Android 16 的两参构造函数委托给带 layerHandle 的三参版本。下方是该版本的部分初始化:
1 | private Choreographer(Looper looper, int vsyncSource) { |
FrameHandler
1 | private final class FrameHandler extends Handler { |
Android 16 的 MSG_DO_FRAME 是未使用 Vsync 时的定时回退;正常 Vsync 走下面的 Receiver Runnable,不要把两条入口混为一谈。
Choreographer 初始化链
首次把 Activity 窗口加入 WindowManager 时,创建 ViewRootImpl 会取得 Choreographer。下面是旧版调用链示意,并非每次 onResume 都重新创建,也不是唯一初始化时机:动画代码也可更早调用 getInstance()。
1 | ActivityThread.handleResumeActivity(IBinder, boolean, boolean, String) (android.app) |
FrameDisplayEventReceiver 简介
Android 16 的 onVsync() 保存时间和一份事件数据,投递异步 Message;随后 run() 才调用 doFrame()。scheduleVsync() 继承自 DisplayEventReceiver,Native 指针由父类管理。下方省略校验和其他字段:
1 | private final class FrameDisplayEventReceiver extends DisplayEventReceiver |
Choreographer 中 Vsync 的注册
Vsync 到来时,onVsync() 到底是怎么被调用的?先沿初始化过程看文件描述符是怎么注册的。下面三段是 Android 10 的注册骨架,不能与上一节 Android 16 的三参 Receiver 构造直接拼接。DisplayEventReceiver 经 JNI/native 建立连接,并把接收 FD 注册到 native Looper。
1 | private Choreographer(Looper looper, int vsyncSource) { |
1 | public FrameDisplayEventReceiver(Looper looper, int vsyncSource) { |
1 | public DisplayEventReceiver(Looper looper, int vsyncSource) { |
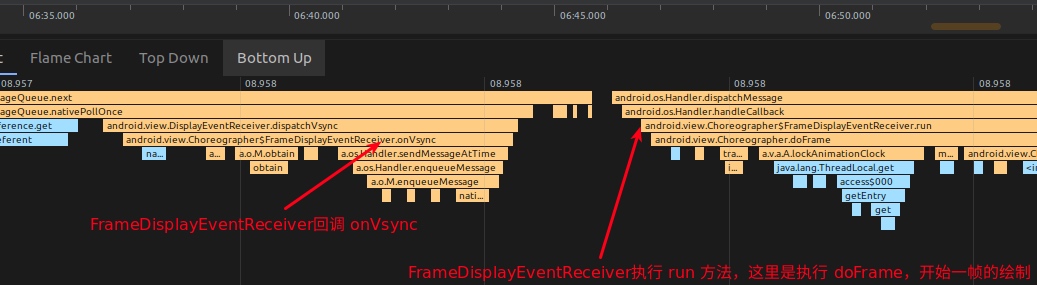
Vsync 事件数据经 BitTube(socket pair)传送;申请下一次通知则经 IDisplayEventConnection.requestNextVsync() 的 Binder 调用。图中清楚分为 nativePollOnce→onVsync 入队,以及后续 Message 分发→run/doFrame 两段。
DisplayEventReceiver 与 SurfaceFlinger 的通信细节
按 Android 10 的 native DisplayEventReceiver,客户端创建连接后,通过 Binder stealReceiveChannel() 取得 BitTube 接收端。下图把控制请求和事件传输分开;不是 App 通过 socket 直接请求下一次硬件中断:
1 | App / DisplayEventReceiver SurfaceFlinger / EventThread |
FD 监听能融入 Looper 事件循环,但仍会受到线程调度和队列工作影响,不提供“精确实时执行”的保证。
Choreographer 处理一帧的逻辑
正常 Vsync 路径先通过 onVsync() 投递 Receiver Runnable,再由 Looper 分发调用 run()/doFrame()。下面重复展示 Android 16 的核心片段,省略了时间戳校验与 pending 状态检查:
1 |
|
doFrame() 检查是否有已安排的帧、处理开始相对携带帧时间的延迟、更新帧信息,然后执行到期阶段回调。这里的 skippedFrames 是开始延迟的诊断估算,不是最终屏幕掉帧统计。
记录帧绘制信息
android.graphics.FrameInfo 是 Framework/HWUI 共用的隐藏内部结构,记录部分阶段边界;不是每个函数或 callback 的完整耗时。下面字段来自 Android 16,展示到 FRAME_INTERVAL,省略 FLAGS 等外围声明和后续 WORKLOAD_TARGET。后文旧 gfxinfo framestats 的表头不同,不能用这里的新下标去解旧 CSV。
1 |
|
Android 16 的 setVsync() 包含 vsyncId、deadline、开始时间和 interval 等六个参数;阶段标记在对应回调前写入,简化如下:
1 | void doFrame(long frameTimeNanos, int frame, VsyncEventData vsyncEventData) { |
执行 Callbacks
Android 16 此处传给 doCallbacks() 的第二个参数是 frameIntervalNanos,不是旧版的 frameTimeNanos。以下 Input/Animation/Traversal 路径是旧版骨架和历史栈示例;每阶段只取已经到期的回调。
1 | void doFrame(long frameTimeNanos, int frame, VsyncEventData vsyncEventData) { |
Input 回调调用栈
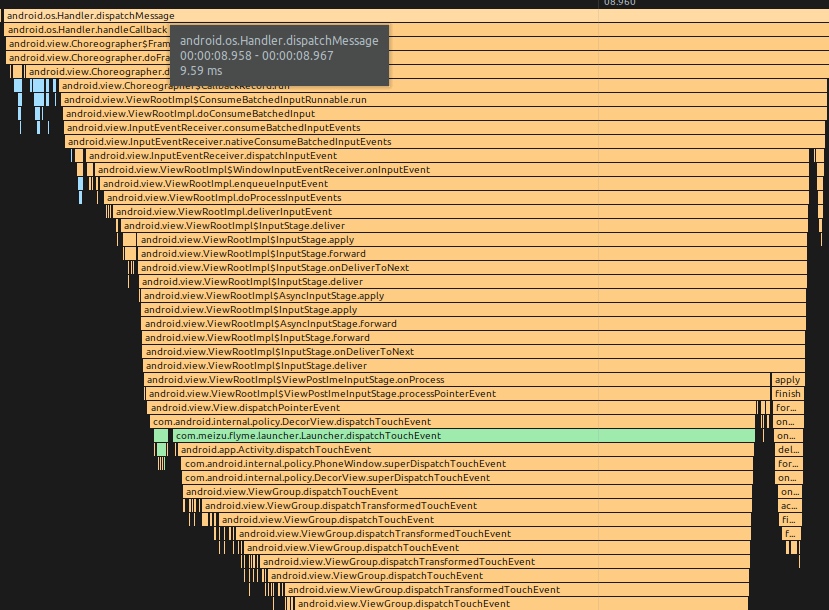
input callback 一般是执行 ViewRootImpl.ConsumeBatchedInputRunnable
android/view/ViewRootImpl.java
1 | final class ConsumeBatchedInputRunnable implements Runnable { |
图中是批量触摸输入经 ViewRootImpl 各输入阶段到 DecorView/Activity/View 的一条路径。按键和未批处理的输入不一定等到 CALLBACK_INPUT;也不是所有输入都调用 dispatchTouchEvent。
Animation 回调调用栈
一般我们接触的多的是调用 View.postOnAnimation 的时候,会使用到 CALLBACK_ANIMATION
1 | public void postOnAnimation(Runnable action) { |
哪些代码会调用 View.postOnAnimation?我截了一张调用层次图,可以看到 startScroll、Fling 等操作。
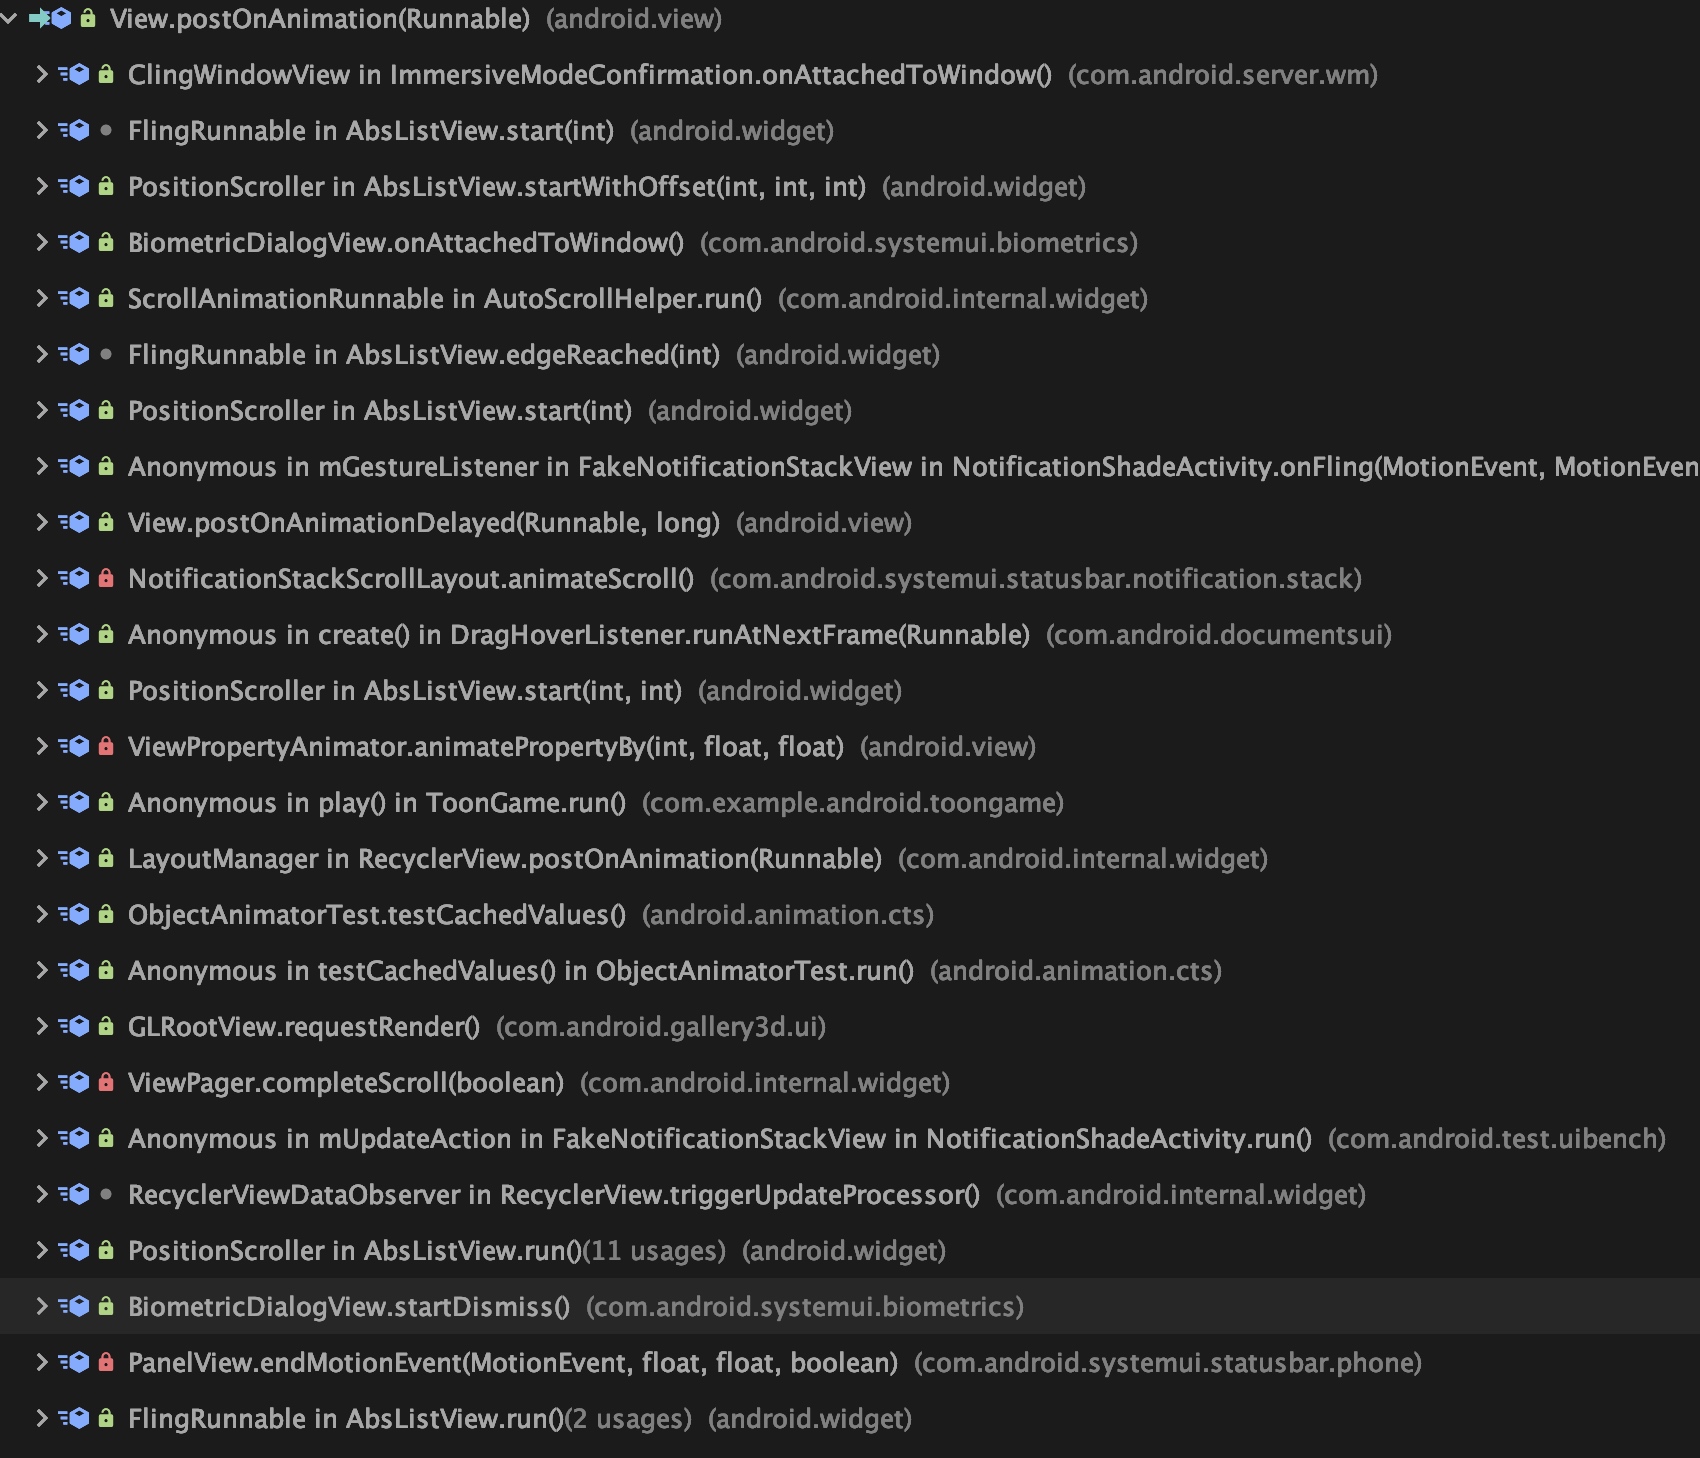
静态调用层次中有 fling 等调用方,但下面这张实际栈显示 AnimationHandler、ValueAnimator/AnimatorSet 和属性更新;不能只凭它认定是某个 FlingRunnable。
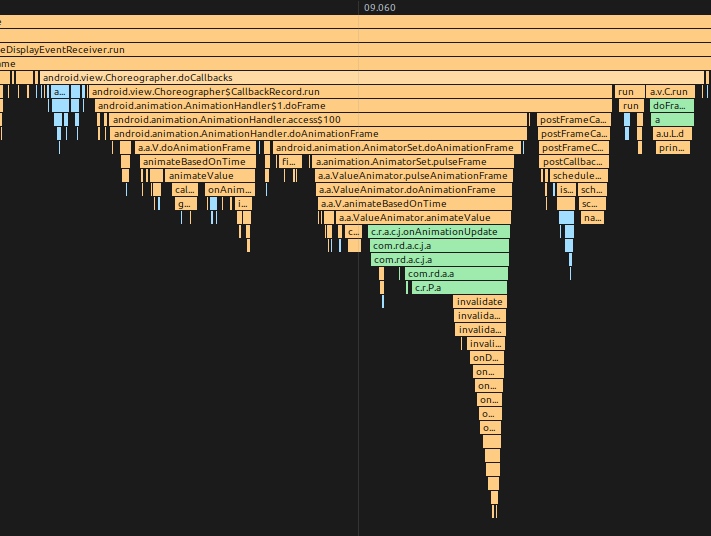
另外我们的 Choreographer 的 FrameCallback 也是用的 CALLBACK_ANIMATION
1 | public void postFrameCallbackDelayed(FrameCallback callback, long delayMillis) { |
Traversal 调用栈
下面省略了外围局部变量和分支,仅说明 schedule→doTraversal→performTraversals 的关系。measure/layout/draw 各有条件,不是每次遍历都完整执行;屏障在 performTraversals 之前移除,不是等 GPU 或显示完成再移除。
1 | void scheduleTraversals() { |
doTraversal 的 TraceView 示例
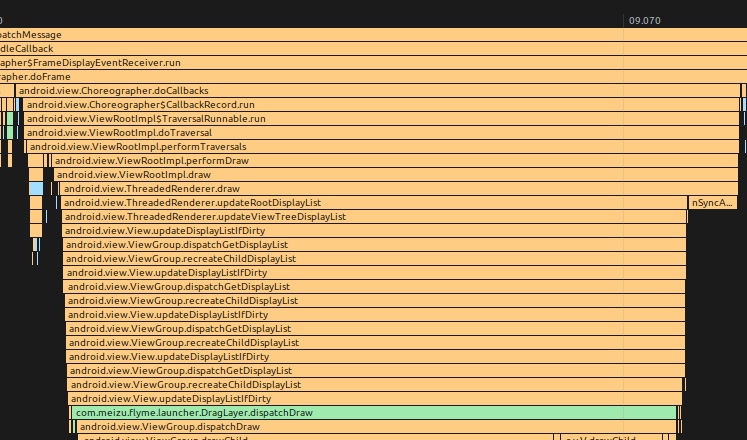
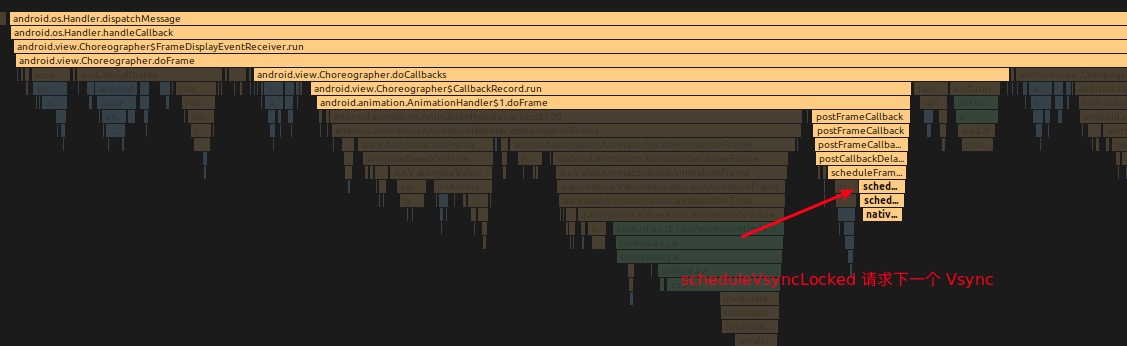
下一帧的 Vsync 请求
由于动画、滑动、Fling 这些操作的存在,我们需要一个连续的、稳定的帧率输出机制。这就涉及到了 Vsync 的请求逻辑,在连续的操作,比如动画、滑动、Fling 这些情况下,每一帧的 doFrame 的时候,都会根据情况触发下一个 Vsync 的申请,这样我们就可以获得连续的 Vsync 信号。
看下面的 scheduleTraversals 调用栈(scheduleTraversals 中会触发 Vsync 请求)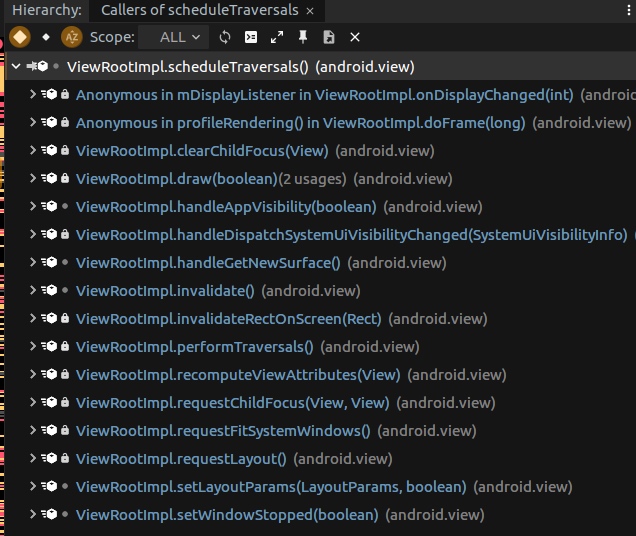
invalidate() 和 requestLayout() 可促成遍历调度,但请求受可见性、已有待处理遍历和 mFrameScheduled 等状态合并,不能按每调用一次就产生一次独立 Vsync 计数。
我们下面以 Animation 为例,看看 Animation 是如何驱动下一个 Vsync ,来持续更新画面的
ObjectAnimator 动画驱动逻辑
android/animation/ObjectAnimator.java
1 | public void start() { |
android/animation/ValueAnimator.java
1 | private void start(boolean playBackwards) { |
android/animation/AnimationHandler.java
1 | public void addAnimationFrameCallback(final AnimationFrameCallback callback, long delay) { |
调用 postFrameCallback 会走到 mChoreographer.postFrameCallback ,这里就会触发 Choreographer 的 Vsync 请求逻辑
android/animation/AnimationHandler.java
1 | public void postFrameCallback(Choreographer.FrameCallback callback) { |
android/view/Choreographer.java
1 | private void postCallbackDelayedInternal(int callbackType, |
上面由 AnimationHandler 在还有动画回调时重新 post 自己,形成连续动画;FrameCallback 本身是一次性的。延迟和无待处理工作时不保证每个 Vsync 都有回调。
动画过程中一帧的 TraceView 示例
源码小结
getInstance()是当前 Looper 线程的默认实例入口,不是全进程单例,也不能推广成框架内部永远不允许同线程有其他 Choreographer。- Binder 控制请求、BitTube 事件、native FD 回调和 Java 异步 Message 是不同环节;没有直接把硬件中断当 Java 绘制执行。
- 五阶段处理顺序给输入/动画更新先于遍历的机会,但只运行到期工作;COMMIT 不是 GPU fence 或显示完成通知。
- ListView/RecyclerView 的布局、绑定、滚动和预取可能出现在不同调用路径。ViewHolder 复用不是 Choreographer 的独立阶段,也不能据此推导 RecyclerView 一定更快;按库版本和实际 trace 定位。
- 一次 FrameCallback 运行后被移除,动画靠继续注册维持节奏。框架协调时序,不保证每个回调都按时或每个 buffer 都能呈现。
APM 与 Choreographer
先区分监控对象:帧回调节奏、Window/HWUI 处理、SurfaceFlinger 呈现、一次 Looper 消息,都不是同一个指标。FrameInfo 是隐藏内部结构,应用不应把反射它当稳定接口。
- API 16 FrameCallback:观察回调节奏,间隔增大可提示延迟,但不是实际显示 fps。
- API 24 FrameMetrics:按窗口接收帧报告;listener 文档中的
dropCountSinceLastInvocation是丢失的报告数,不是显示丢帧。回调中的对象会复用,应先复制再异步处理。 - API 33 postVsyncCallback:提供 FrameData 候选时间线、deadline 和 expected presentation 信息;仍是单次回调及调度预测,不是已呈现证明。见 Choreographer API。
- gfxinfo/FrameTimeline:前者读对应版本的 HWUI 数据;Android 12 起的 FrameTimeline 用 expected/actual 与呈现关联辅助判断 jank,要求实际采集到该数据源。
- Looper/IdleHandler:消息分发墙钟和队列空闲可辅助排查,不覆盖 GPU/呈现;IdleHandler 不是每帧结束回调。
下面保留旧监控例子,并标明版本和适用边界。
利用 Perfetto 进行高级监控
Perfetto 可把已启用的调度、CPU 频率、应用 trace section、图形和系统服务数据放到同一时间线上。数据类别、app trace 权限和设备支持决定可见范围;只有插桩点才有 slice,不能自动还原所有函数。采样/堆栈/图形数据各有开销,不能不带配置地承诺比旧工具更低开销。
使用 Perfetto 跟踪 Choreographer
将 com.example.app 换成目标包名。前台命令记录 15 秒,运行后应在记录窗口内操作设备,结束后再 pull;32 MB 只是示例环形 buffer 大小,不保证覆盖全部窗口。类别依设备版本可用性调整。
1 | # 开始记录 Perfetto trace(示例:15 秒,常用类别) |
可搜索 Choreographer#doFrame(有的版本名称带帧 ID),但它是 Choreographer 回调处理 slice,不是 GPU/最终呈现的完整时长。需要 FrameTimeline 时另配置 android.surfaceflinger.frametimeline;本条简写命令不保证自动启用。完整配置示例见采集篇。
利用 framestats(底层依赖 FrameInfo)进行监控
命令形式为 adb shell dumpsys gfxinfo <packagename> framestats,执行前替换包名。下面是原文 StatusBar 历史输出,不是本轮采集结果:
1 | Window: StatusBar |
CSV 必须按自身表头解析。时间点与 DequeueBufferDuration/QueueBufferDuration 这类持续时间要分开,单位为 ns;FrameInfo 使用单调时钟,不是日历时间。旧字段 OldestInputEvent=9223372036854775807、NewestInputEvent=0 是未记录输入的哨兵,不能拿来算巨大的输入延迟。
FrameCompleted 是该 HWUI 路径的完成标记,不等于物理显示时间。Summary 的 Missed Vsync/Slow UI 等分类可重叠,不应相加当作独立帧总数;旧样例与 Android 16 FrameInfo 字段布局不相同。
利用 SurfaceFlinger 进行监控
旧版可先用 adb shell dumpsys SurfaceFlinger --list 找 layer,再查询对应的 --latency,例如 adb shell 'dumpsys SurfaceFlinger --latency "实际 layer 名称"'。只给 --latency 不等于已选中某个 App;实现和权限依设备版本而异。
以 Android 10 FrameTracker 为参照,首行为刷新周期,后面三列为 desired present、actual present、frame ready 时间(ns)。该版本 ring 有 128 个槽,dump 遍历 127 个;不是固定拿到 128 个新有效帧。0、未完成 fence 的 INT64_MAX 等记录须识别为无效/未完成。
原来的 ceil((C - A) / refresh_period) 只涉及 ready 与 desired 的差值,没使用 actual present,不能当作通用丢帧公式;高刷新率切换、流水线期限和缺失值也会影响估算。现代分析优先关联 FrameTimeline 的帧与呈现数据。
利用 SurfaceFlinger PageFlip 机制进行监控
此接口已过时,只保留历史说明。 Android 10 的私有事务码 1013 曾返回默认显示的 page-flip 计数,受 system UID/HARDWARE_TEST 等系统权限检查约束,不是某个 App 的 fps。Android 16 对同一码直接返回 NAME_NOT_FOUND。原文直接 transact() 后 readInt() 的做法未处理失败,不再作为可用监控示例。
1 | // android-10.0.0_r1: selected SurfaceFlinger::onTransact branch |
这是两个版本的独立节选,不是同一个 switch。新实现请按监控对象选择 FrameMetrics 或 FrameTimeline;不支持、权限不足和无数据不能记成 0 fps。Android 16 SurfaceFlinger
Choreographer 自身的掉帧计算逻辑
以下是旧式简化节选。jitterNanos 指实际开始相对该次携带帧时间的延迟;整除 interval 是错过节拍的诊断估算,不是这次 doFrame 的执行时长或最终呈现丢帧数。Android 16 按事件的 frameInterval 计算,并处理 interval=0 等分支。
1 | if (jitterNanos >= mFrameIntervalNanos) { |
SKIPPED_FRAME_WARNING_LIMIT 默认 30,属性在类初始化时读取。没有达到输出门槛不表示没有卡顿;改日志门槛也不会修复卡顿。
BlockCanary
BlockCanary 的历史思路是通过 Looper MessageLogging 观察消息分发前后。下方旧 Looper 骨架只说明日志位置,新版可能拆成 loopOnce 等实现;不是当前库的安装建议或维护状态保证。
1 | public static void loop() { |
测得的是 dispatch 墙钟时间,包含同步等待和调度延迟,不是纯 CPU;它不覆盖 nativePollOnce 的全部 FD 工作、GPU 或显示。连续短消息也可能使后续帧迟到。日志回调有开销,并应与其他使用同一 Looper logger 的工具协调。
MessageQueue 与 Choreographer
同步屏障是队列机制,不是 CPU 优先级提升。以 Android 10 MessageQueue.next() 为例,队首为屏障(target 为 null)时会寻找后续异步消息,再检查它是否已到执行时间;它不会抢占当前正在运行的回调,也不是另开线程。
框架内部用 postSyncBarrier()/removeSyncBarrier() 管理屏障,这些不是应用稳定公开 API。Message.setAsynchronous(boolean) 自 API 22 已公开,Handler.createAsync() 自 API 28 公开;旧文把 setAsynchronous 标成隐藏方法是错误的。没有阻挡它的屏障时,异步标记不会自动把消息移到队首,跨 Handler 的顺序依赖也不能被忽略。
SyncBarrier 在 Choreographer 中使用的一个示例
scheduleTraversals 的时候 postSyncBarrier
1 | void scheduleTraversals() { |
doTraversal 的时候 removeSyncBarrier
1 | void doTraversal() { |
这些帧调度 Message 使用异步标记,以便在屏障生效时仍可分发;不要把它描述为提高 Linux 调度优先级或永远先于所有消息执行。
1 | Message msg = mHandler.obtainMessage(MSG_DO_SCHEDULE_CALLBACK, action); |
厂商优化
系统厂商由于可以直接修改源码,也利用这方面的便利,做一些功能和优化,不过由于保密的问题,代码就不直接放上来了,我可以大概说一下思路,感兴趣的可以私下讨论
下面是我当时的一些工程思路,不是 AOSP 默认行为或所有固件已验证的收益。实际修改需要维持输入/生命周期顺序、动画时间基准和 buffer/fence 合同,并比较延迟、呈现、功耗与兼容性。
移动事件优化
Choreographer 已有 CALLBACK_INPUT,ViewRootImpl 可在这里消费批量输入;不能说它完全没有 input。厂商可以把更多输入状态用于更早调度,但需要区分接收、批量消费和应用回调,验证事件顺序、重采样及输入到呈现延迟。
后台动画优化
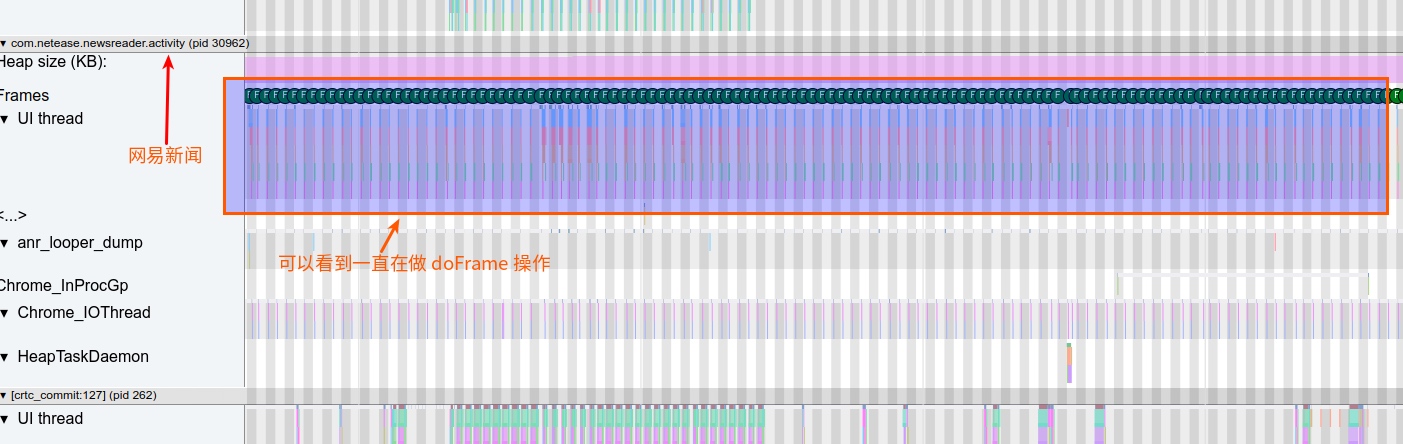
不可见且没有业务必要的动画,可以结合生命周期/可见性停止更新。厂商也可研究受控限制,但“后台”不自动等于所有回调无意义,需考虑多窗口、画中画和状态推进等情形。下面旧图可见密集 doFrame,我当时标注的是后台场景;图本身没有独立的可见性、功耗或固件配置证据,不能据此评判现在同一应用的行为。
帧绘制优化
厂商可研究在特定场景提前调度合成,而不机械等待原计划的软件时序;这不表示显示面板可以任意时刻呈现。SurfaceFlinger/HWC 仍需满足 buffer、fence、显示 deadline 和功耗约束,不能仅凭“提前做合成”推断少掉帧。
应用启动优化
启动关键消息被排队工作延迟时,可以先定位无关耗时和等待,再考虑受控调度。直接把任意启动 Message 移到队首可能破坏生命周期、输入顺序或让其他任务饥饿;收益应以首帧/可交互时间和回归场景验证,不能只看某条消息更早运行。
animation callback 前置
上一帧主线程工作结束到下个 Vsync 之间可能有余量,但不保证 CPU 空闲;其他消息、线程和 GPU 仍可工作。提前计算动画需要保持 frameTime、属性更新及输入采样的一致性。它属于特定框架策略,不能默认提前执行就减少 jank。
插帧
这里更接近厂商预渲染/预测后续动画状态的构想,不能把“一个 Vsync 调两次 doFrame”定义为通用插帧。doFrame 有已调度状态、单调帧时间和回调队列约束;多执行一次不等于生成、提交或呈现第二帧,也不等于图像运动补偿。
OverScroller 可根据当前速度/边界预测滚动,但新输入、碰边、布局与内容变化会使预测失效。若尝试提前准备,必须处理取消、时间基准、额外 buffer/功耗和真实呈现节奏;不能声称 touch up 时已确定之后每帧的全部内容。
高帧率优化
当显示模式实际工作在 120 Hz 时,刷新间隔约 8.33 ms,而不是 60 Hz 的 16.67 ms;应用出帧率仍可能不同。优化应同时观察工作期限、帧呈现节奏和能耗,而不是把整个流水线都塞进固定的单线程预算。厂商需要评估的方向包括:
- 超级 App 的性能表现以及优化
- 游戏高帧率合作
- 120 fps、90 fps 和 60 fps 相互切换的逻辑
参考资料
- https://www.jianshu.com/p/304f56f5d486
- http://gityuan.com/2017/02/25/choreographer/
- https://developer.android.com/reference/android/view/Choreographer
- https://www.jishuwen.com/d/2Vcc
- https://juejin.im/entry/5c8772eee51d456cda2e8099
- Android 开发高手课
- Perfetto - System profiling, app tracing, and trace analysis
- Perfetto UI 官方使用指南
- BufferQueue and Gralloc
- Android 15 官方功能说明:图形相关内容
本文知乎地址
由于博客留言交流不方便,点赞或者交流,可以移步本文的知乎界面
知乎 - Android 基于 Choreographer 的渲染机制详解 - Perfetto 版
掘金 - Android 基于 Choreographer 的渲染机制详解 - Perfetto 版
关于我 && 博客
下面是个人的介绍和相关的链接,期望与同行的各位多多交流,三人行,则必有我师!
- 博主个人介绍 :里面有个人的微信和微信群链接。
- 本博客内容导航 :个人博客内容的一个导航。
- 个人整理和搜集的优秀博客文章 - Android 性能优化必知必会 :欢迎大家自荐和推荐 (微信私聊即可)
- Android 性能优化知识星球 : 历史介绍(已停止运营)
一个人可以走的更快 , 一群人可以走的更远