上一篇 OpenClaw 实战复盘发出去之后,后台留言和群里讨论最多的就是这几个方向的问题:Token 消耗、能干什么、本地模型、隐私安全、使用体验。今天挑出被问频率最高的五个,一个一个说清楚。
历史与核查说明(2026-10):本文的个人经历和用量记述来自 2026 年 3 月,原文未附账单明细或执行日志。旧价格表已过期,不能作为今天的购买依据;本次按官方现行说明补充计费边界,OpenClaw 配置语义固定参照 v2026.10.3。所有配图均为概念示意,Token 趋势图和状态卡片也不是后台实测截图。
1. Token 消耗到底多少?贵不贵?
先说结论:没你想的那么贵,但也不是零成本。我前后用了两套方案,一套云端套餐,一套国产性价比路线,感受差异还是挺明显的。
前期:ChatGPT Pro(历史选择)
我最初使用的是当时记述为 200 美元/月的 ChatGPT Pro,并把一部分额度用于日常编码。我当时没有遇到用量限制,不代表所有任务都无限量,也不能据此把订阅费当成 OpenAI API 余额。
OpenAI 官方定价说明区分订阅用量与 API token 价格;Sign in with ChatGPT也区分“登录”与“允许应用使用套餐”两种授权。OpenClaw 的接入还要区分订阅登录与 API Key 路径。原文未记录当时的完整鉴权与账单归属,因此不据此推导任何 API 都包含在 Pro 内,也不把当年的 5 小时/周额度描述当作当前规则。
后期:智谱 GLM Coding Plan(历史选择)
Pro 到期后,我当时转用了智谱 Coding Plan,原文记下的促销购买价是 ¥980/年。这段个人购买经历保留;旧稿中 ¥1608/年、约 30% 涨幅与“季度价乘四”并非同一种价格口径,没有对应订单/公告就不能相互证明。下面把历史记录与当前套餐规则分开。
2026 年 3 月套餐记录(已过期)
原价格表已过期,且不是经过核验的年付报价。 季费乘四只能得到连续买四季的算术合计,不能代替平台的年付/续费/优惠价格;这里撤下旧报价和推荐标签。
截至 2026 年 10 月核查,智谱官方套餐概览列出 GLM-5.3/GLM-5.3-Flash,并按输入、缓存命中、输出及工具调用消耗积分。它支持 OpenClaw,但明确采用次级调度、尽力交付,高负载时可排队或限流。
| 档位 | 官方列出的 5 小时积分 | 每周积分 |
|---|---|---|
| Lite | 2,000 | 10,000 |
| Pro | 12,000 | 60,000 |
| Max | 28,000 | 140,000 |
这是核查时的额度规则,不是 token 包量或无限 API。购买金额、地域与续费条件以实际订单页为准;套餐仅在支持的工具和正确接入路径中生效。
GLM-5 API 按量计费(如果不用套餐)
原 GLM-5/GLM-5-Code 单价表未附可复核的历史报价,也不能当作当前价格。按量核算应使用实际调用的模型、端点和账单费率,至少区分:
| 费用项 | 所需数据 |
|---|---|
| 未缓存输入 | 未缓存输入 token × 对应单价 |
| 缓存输入 | 缓存命中 token × 缓存单价 |
| 输出 | 计费输出 token × 输出单价 |
| 其他 | 适用的工具、搜索、音频等费用 |
单价按“每百万 token”标示时,先将对应数量除以一百万再相乘,避免把缓存 token 重复算入未缓存输入。只知道 2.4 亿总 token,没有输入/输出/缓存拆分,算不出 ¥2400 的真实账单。订阅限额和按量费用也不是可直接兑换的两种额度。
国内 Coding Plan 对比(2026 年 10 月核查)
旧表中的价格、模型与星级推荐已过期,也没有统一任务评测支持“最好”“能力接近”的结论。2026 年 10 月核查时,三家的产品和规则已经变化:
| 提供方 | 官方页面反映的变化 | 接入前核对 |
|---|---|---|
| 智谱 | GLM-5.3 系列、积分制,OpenClaw 为次级调度 | 支持工具、端点、5 小时/周积分 |
| MiniMax | 原入口现为 M Plan,Go/Explore/Build;支持 OpenClaw | 所购权益、模型与 M Plan Key,不能沿用旧 Starter/Plus/Max 价格 |
| Kimi | 新老会员并存;新套餐取消周窗口,仍有 5 小时窗口和月额度 | 账号所属套餐;Kimi Code 与开放平台 API 是不同计费路径 |
因此不再按旧差价推荐直接买年费。先确认任务获该套餐支持,用自己的工作量试用,再比较成功率、延迟、限额与实际成本。
真实数据:7 天烧了 2.4 亿 Token
我当时查了智谱后台,看到“7 天约 2.4 亿 token”,这个数字看着挺吓人。算下来日均约 3429 万 token,但我没有在文中附上计费明细、输入/缓存/输出分类或同期本地计数,不能进一步推导实际 API 账单、本地占比或年套餐节省额。
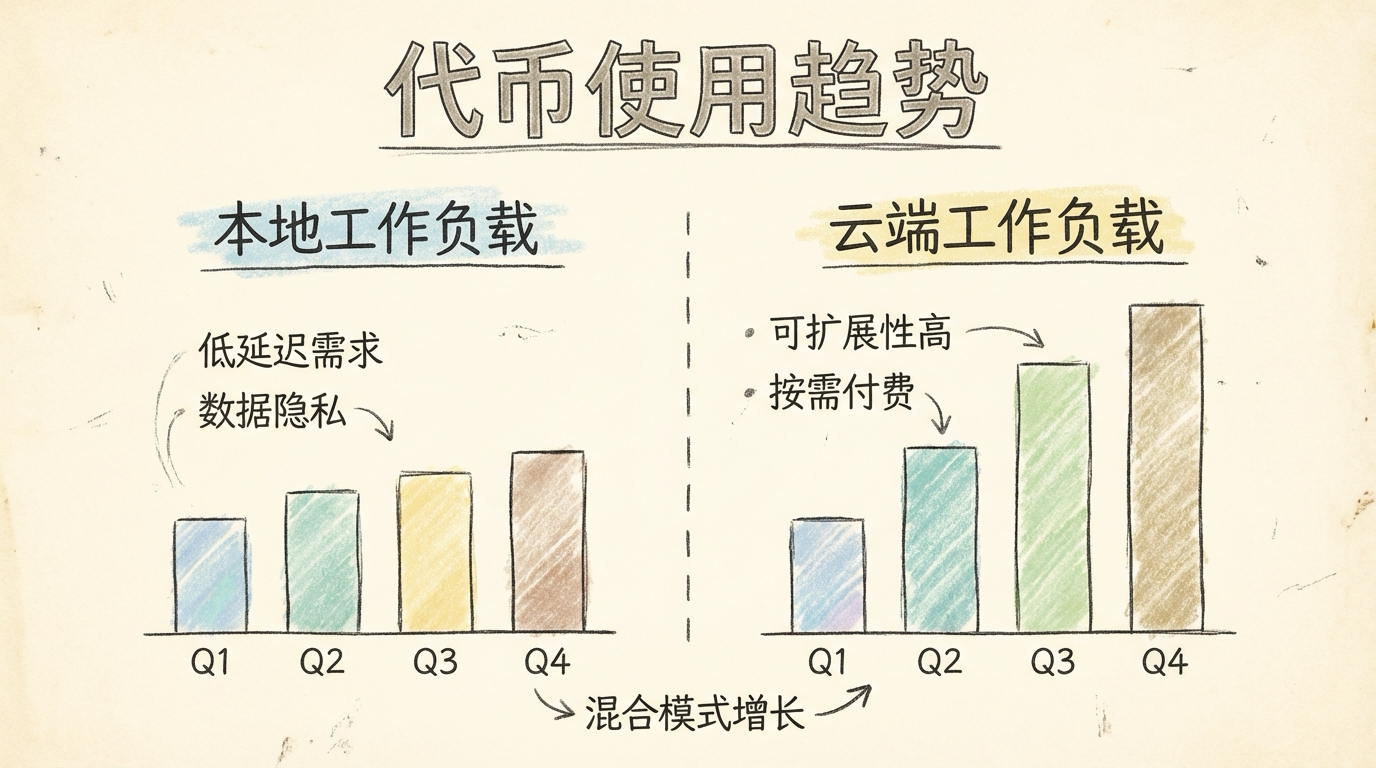
上图只有概念性的 Q1–Q4 趋势,不是这 7 天的用量截图。云端、本地的分工仍是我当时的实践选择;是否更便宜,需同时核算云端费用、本地运行成本和任务成功率。
心态:别太功利
说到费用,我想多聊两句心态。养了这么久 OpenClaw(我家小朋友叫它”虾哥”),我最大的感触是:别一开始就想着变现、ROI 这些功利性的东西。AI 时代才刚刚开始,前期投资是必须的。你现在投入的时间和金钱可能暂时看不到直接收益,但会慢慢转化成你对 AI 能力边界的理解、对 Agent 协作的体感、对”什么场景能用 AI 解决”的直觉判断力。这些东西短期内没法量化,但长期来看价值巨大。
我的态度一直是:养虾就当给自己买了个大玩具,千金难买我开心。每天看它自己跑任务、写文章、整理知识库,这件事本身就已经很有成就感了。以后能变现当然好,但不能用”现在能不能变现”来决定要不要开始。先养起来,比什么都重要。
2. OpenClaw 到底能干什么?给几个实际的例子
上一篇实战复盘写得比较详细,但我知道很多人没耐心从头看到尾。这里直接捞几个我觉得最有价值、最能说明问题的场景出来。
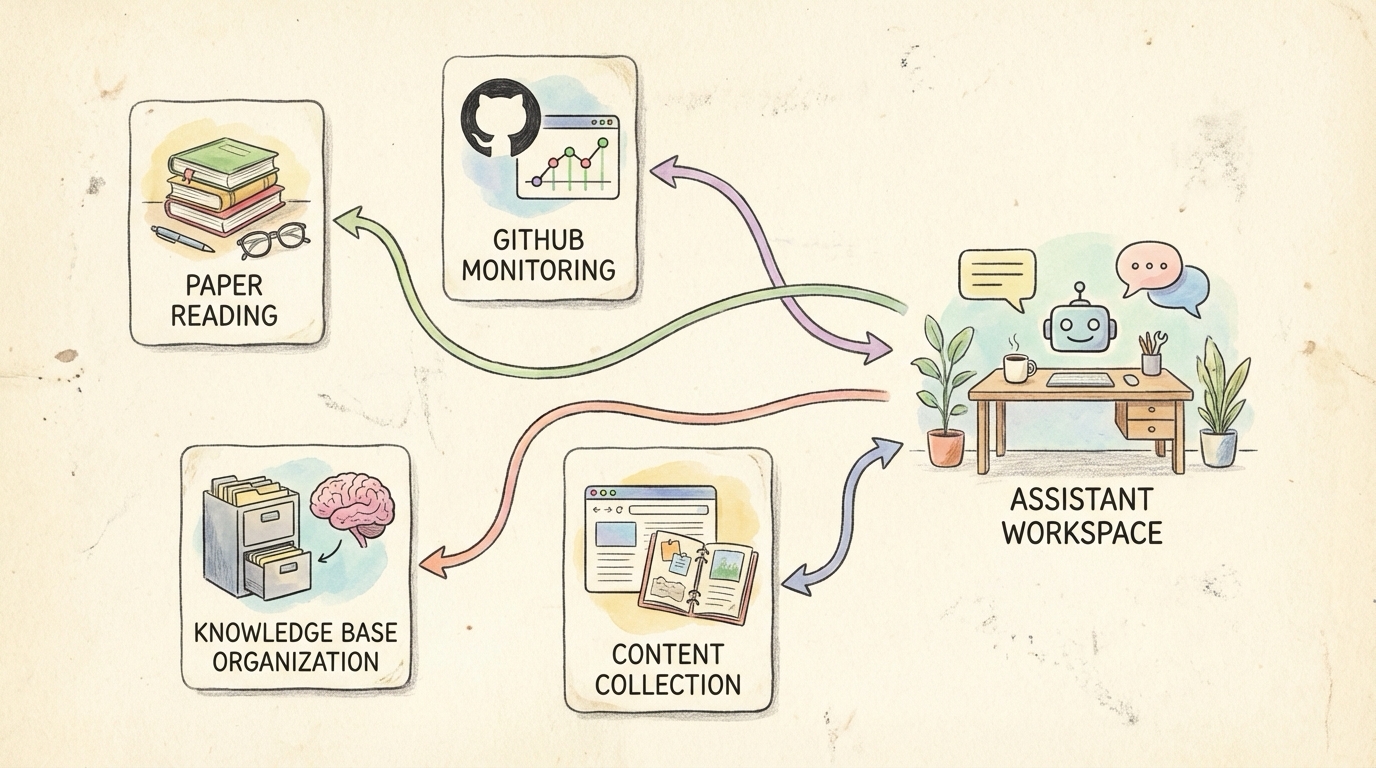
我正在用的
| 场景 | 说明 | 价值 |
|---|---|---|
| 每日论文精读 | 自动抓 Android/AI 论文 → 翻译 → 精读笔记,落盘到 Obsidian | 减少资料整理工作,仍需核对来源与结论 |
| GitHub 仓库监控 | 巡检 Issue/PR 变化,重要更新主动通知 | 我监控的是 Perfetto,不用每天刷 |
| 知识库建设 | 公众号/X/博客自动归档、结构化 | 1760 篇 Markdown 持续增长 |
| 内容回顾 | 每天推送值得重看的内容 | 解决”收藏了再也没看过” |
| Android 动态汇总 | 自动汇总领域动态,提取关键话题 | 不用刷信息流 |
核心价值在于,OpenClaw 最值钱的是把那些你明知很重要、但凭意志力很难长期坚持的事情变成系统默认帮你执行的后台任务。
进阶案例 1:批量导入 NotebookLM 进行深度分析
NotebookLM 可基于导入资料生成回答和音频概述;双主持人播客是其中一种呈现方式。它本身也支持一次添加多个来源:官方帮助说明可以批量输入网页 URL、选择多个 Drive 文件,不必每次都一条一条手动添加。
OpenClaw 可以承担资料搜集、整理和连接这些步骤,但要有相应工具、登录状态与权限。Google 的 Enterprise 来源 API提供 sources.batchCreate,属于对应 Cloud 产品、项目与授权范围,不能把它写成任意个人 NotebookLM 账号都可直接使用的通用 API。浏览器自动化也是另一条需要维护和验证的接入路径。
实际操作
下面是任务请求示例,不是内置的一键命令:
1 | 我:帮我研究一下 Android 15 的性能优化特性。 |
实现时分别检查搜集到的来源、可访问的正文、导入成功/失败列表和音频生成状态。模型筛选不保证资料质量,提交生成也不等于音频已可播放;来源缺失、登录失效或配额限制都应在结果中保留。
为什么这个组合很香?
| 环节 | 自动化可减少的工作 | 仍需核对 |
|---|---|---|
| 搜集资料 | 按主题搜索、去重、整理来源列表 | 原文可访问性、来源可信度 |
| 导入 | 在支持的接口/页面中批量提交 | 每个来源是否导入成功 |
| 持续更新 | 定期发现新材料并生成摘要 | 是否有实质更新、旧结论是否失效 |
我看重的是减少重复操作,而不是把“自动筛过”当成“已经准确”。
进阶案例 2:扔一个链接,自动抓取所有关联内容并落盘
这是我日常用得最多的场景之一,几乎每天都会触发。刷推或者看公众号的时候看到一篇好文章,里面提到了几篇论文、几个 GitHub 仓库、几个相关链接、几本推荐的书籍。以前的做法你一定不陌生:收藏 → 告诉自己回头看 → 忘记 → 再也没看过。现在有了 OpenClaw,做法变了:
1 | 我:https://example.com/awesome-article |
这类流程要按可访问性和授权逐项处理:可公开获取的论文下载 PDF,网页在可读取且允许保存时提取正文,书籍记录元数据与购买/借阅入口。登录、付费或失效链接可能无法取得全文,不能报告“所有内容都已抓全”。
示例已明确要求 star 和克隆;实际执行仍要限定仓库和数量,克隆不等于运行仓库里的代码。最后的 Markdown 应记录成功项、失败项、原始 URL 和落盘位置。Personal-Knowledge/source/ 是这里的个人目录约定,不是 OpenClaw 默认输出位置。
如果你是 Android 开发者
这是我目前还没做但正在规划中的方向,列出来看看有没有跟你产生共鸣的场景:
| 常见问题 | OpenClaw 能做什么 | 适用 |
|---|---|---|
| Trace 分析门槛高 | 上传 Perfetto/Systrace → AI 辅助解读 → 生成”人话版”报告 | App 性能优化、系统 UX 性能 |
| 版本适配清单 | 自动抓 Android Release Notes → 生成适配 checklist → 对比代码标记检查点 | App 开发者(每年必做) |
| Issue 堆积难筛选 | 自动分类(bug/feature/question)→ 优先级判断 → 提取关键信息 | 开源维护者、团队协作 |
| Code Review 耗时 | 检测常见问题模式(空指针、资源泄漏、主线程 IO)→ 生成 Review checklist | 所有团队 |
| 技术债务遗忘 | 定期扫描 TODO/FIXME → 按优先级排序 → 定期提醒”该还债了” | 所有项目 |
| Benchmark 没人看 | 定期跑 benchmark → 自动对比历史 → 异常告警(启动 +500ms) | 性能优化团队 |
| 内部文档找不到 | 基于知识库回答”之前遇到过吗?””设计文档在哪?” | 所有团队 |
| 上游变更追踪 | 监控 AOSP/厂商代码变更 → 提醒需要合并的点 | 系统开发者 |
这些能力并不是开箱即用的,需要根据你自己的业务场景做定制开发。但 OpenClaw 的架构天然支持这些方向的扩展——关键是先把基础设施养起来,再根据实际需求慢慢迭代。
一句话总结
论文每天读、仓库每天盯、知识每天理、日报每天写。它真正做到的是,把”需要长期坚持”这件反人性的事情变成了”系统在后台默默帮你执行”。
3. 本地模型可以干什么?
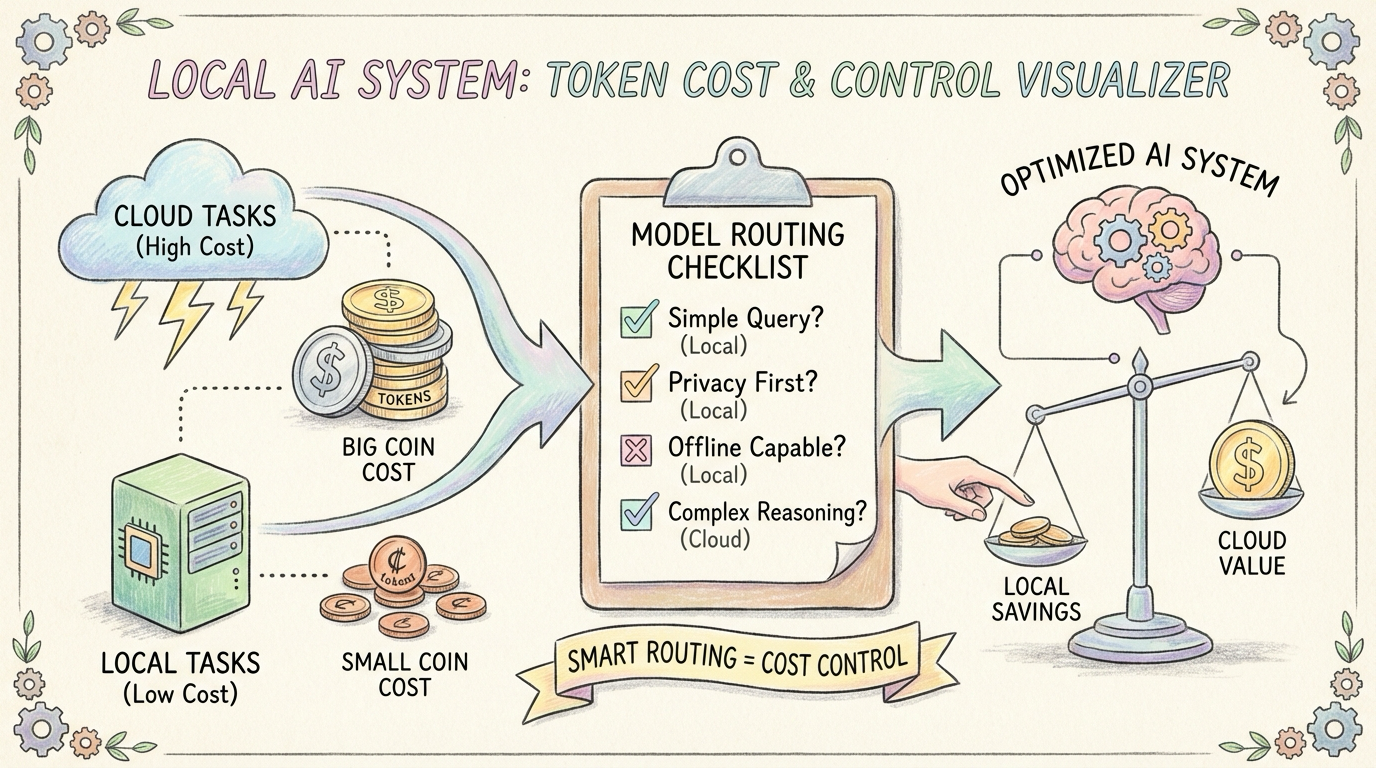
在我当时的工作流里,本地模型主要负责高频重复任务。一句话概括分工:云端“想得深”,本地“跑得勤”。
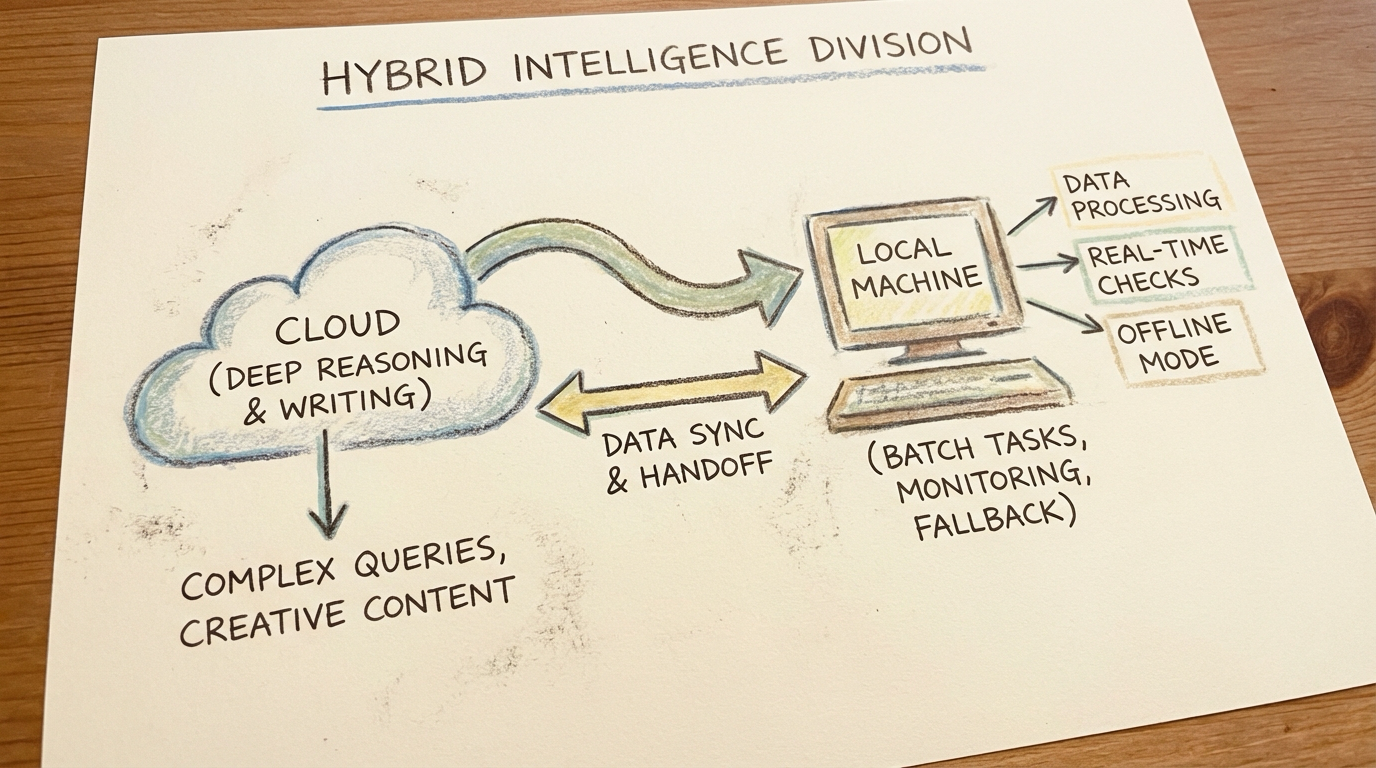
本地模型承担了多少?
这是我当时记下的任务分配;没有附统计窗口、任务计数规则和原始日志:
| 任务类型 | 模型 | 占比 |
|---|---|---|
| 巡检、监控、批处理 | 本地 Qwen3.5-27B | 30% |
| 状态检查、轻量分类 | 本地 Qwen3.5-4B | 20% |
| 极轻任务 | 本地 Qwen3.5-2B | 10% |
| 云端失败降级 | 本地 Qwen3.5-9B | 5% |
| 长文、精修、复盘 | 云端 GLM5 | 15% |
| 日报周报、审计 | 云端 GLM5 | 10% |
| 论文精读、ClawFeed | 云端 GLM5 | 10% |
表中本地任务比例合计为 65%,云端为 35%;这是表内算术,不是重新验收的运行结果。任务比例不能推出 token 比例,原“本地 80%+ token”缺少同时间窗的本地计数与统计定义,因此不保留为已证实结论。
我的配置
硬件是一台 Mac Studio(M 系列 Apple Silicon),上面部署了多个规格的本地模型:Qwen3.5-2B/4B/9B 使用 MLX 8bit 量化,负责轻量任务和云端故障时的容灾降级;Qwen3.5-27B 通过 Ollama 部署,承担高频结构化任务,是本地的主力干活模型。MLX 是计算框架,Ollama 是模型运行与服务工具,二者不是只按名称就能比较速度的同类指标。这里没有同模型、同量化、同上下文、同并发的基准,不能据此断言 MLX 一定更快。
分工原则
| 本地适合 | 云端更强 |
|---|---|
| 高频结构化任务(RSS、队列处理) | 长文写作与精修 |
| 巡检与监控 | 复杂推理与判断 |
| 数据预处理(配置为本地执行,另查外联路径) | 高质量翻译与解读 |
| 云端降级接管 | 论文精读、深度分析 |
我当时复用了已购硬件,但本地运行仍有电费、占用、维护和折旧成本。原文没有能耗测量,不能把“没有逐 token 账单”写成成本为零。
烧 Token 的速度
我当时搭配使用 GPT-5.4、GLM5 和 Qwen3.5 系列。这是那时的配置,不代表当前默认模型或推荐榜。是否选 Coding Plan,要先确认任务/工具在支持范围内,以及额度窗口、并发与队列策略;没有“量大管饱”的通用保证。对持续自动化任务,按实际输入、缓存、输出和失败重试建立用量预算,再决定订阅或按量计费。
备用通道
虾哥前期运行偶尔会出现不稳定的情况,这时候我会用 Claude Code(Remote Control)远程连过去手动排查和救火。这种情况出现的频率不高,但有备用通道在手里心里踏实很多。
分工逻辑
打个比方,本地模型是”勤奋的蓝领工人”,云端模型是”聪明的高级顾问”。OpenClaw 做的事情就是帮你把这套分工协作的逻辑彻底自动化了。
4. 隐私和安全怎么保护?
这个问题被问得非常多,也确实是每个人在决定养虾之前必须认真想清楚的事情。
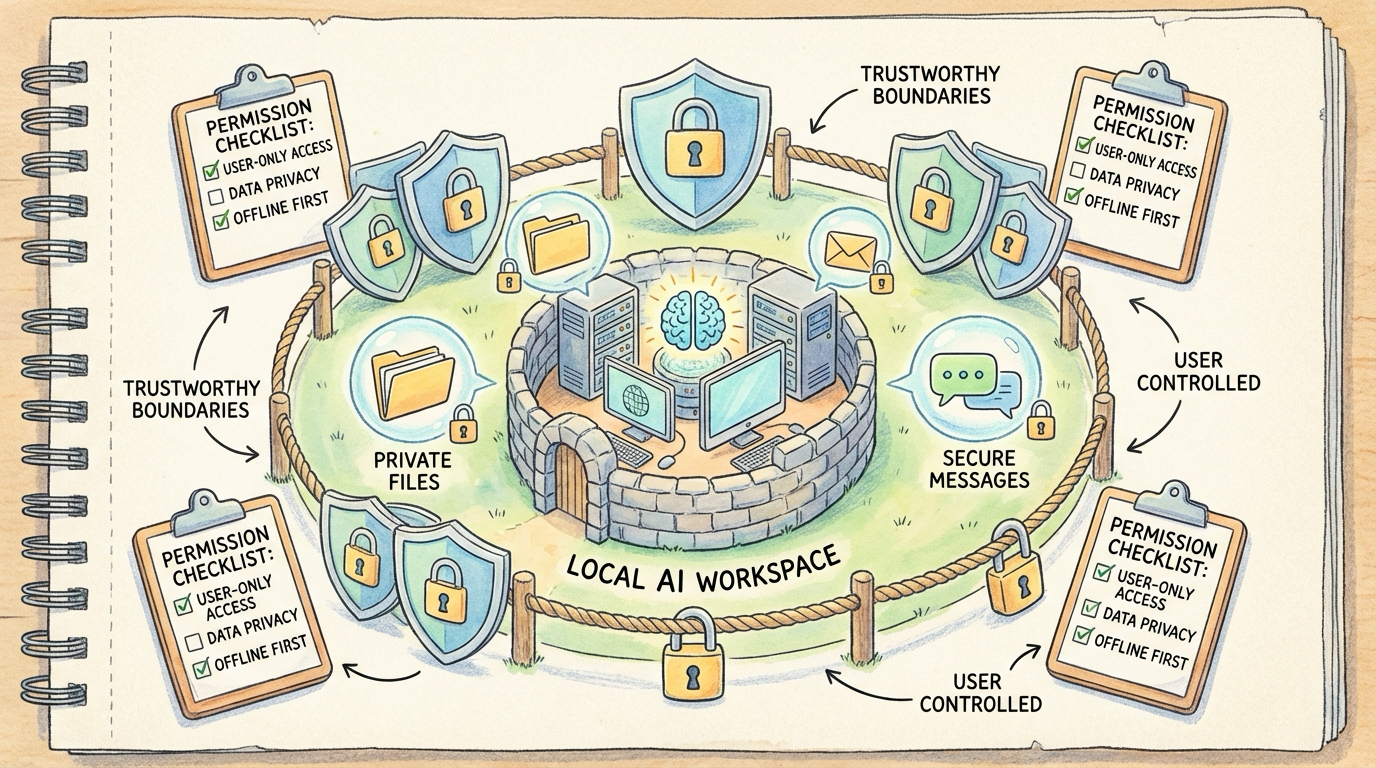
核心原则
敏感数据不离开本机是我的使用目标,不是安装本地模型后自动获得的保证。原文的原则仍适用,但需要验证整条数据路径:
- 敏感文件只交给获准的本地推理与本地工具,不让失败回退、摘要或附件自动流向云端模型。
- Telegram、网页工具、NotebookLM 和 iCloud 都可能把数据送到外部;“本地优先”不等于这些路径不存在。
- 用有效的工具策略、沙箱挂载、宿主机与凭据权限限制访问。工作区路径和 Markdown 里的约定不能单独充当隔离机制。
技术层面的防护
命令执行:按 v2026.10.3 的 safe-bin 说明,tools.exec.safeBins 是 allowlist 模式下受参数约束的 stdin 过滤器快速通道,不是任意命令的“只读认证”。该版本内置默认名单为 cut、uniq、head、tail、tr、wc。git、find 等包含写入或执行能力,不能按命令名整体当作安全只读工具。
deniedFlags 属于具体 safe-bin profile 的参数检查,不是一个会全局拦截所有危险命令的开关。是否执行还取决于 exec host、security/ask 策略、路径 allowlist、工具授权和沙箱;这些措施不能推出“提示注入根本跑不通”。
来源与命令授权:commands 文档中的 commands.ownerAllowFrom 限制仅 owner 可用的管理命令,与 commands.allowFrom、频道配对和普通消息入口不同。Telegram 要核对 channels.telegram.allowFrom、群组策略/groupAllowFrom 等,频道文档另有账户继承规则;原稿笼统的 channels.allowFrom 不能当成所有频道通用配置。能否发命令、能否触发普通 Agent 消息、能否调用某个工具要分别限制。
自定义巡检:每日配置 SHA256 比对和敏感信息扫描,是我当时自己配置的运维方案,不是 OpenClaw 安装后自带的已验证保证。哈希变化可能来自正常修改;要保护基线和告警链路,并检查定时任务是否实际运行。每日检查不是实时检测,敏感信息扫描也可能漏报;没有告警不能证明没有泄漏。
运行层面的隔离
- OpenClaw 跑在独立的 Mac Studio 上,不和我日常开发的机器混用
- 敏感账号(公司邮箱、内部系统)不接入 OpenClaw
- 微信公众号等对外发布渠道,只开放”草稿保存”,不开放”直接发布”
以上是我当时给这套部署划的范围。草稿与发布边界要由实际接口、凭据和工具权限落实;若同一浏览器会话仍可直接发布,仅在指令里写“只存草稿”不构成完整隔离。
信任边界
我希望 OpenClaw 能访问的数据不超出我愿意交给这套系统处理的范围,但不能据此断言它天然比其他 AI 产品更安全。云端请求、Telegram 消息、iCloud 同步和浏览器会话可能形成不同的数据副本;本地日志也可能含敏感信息、缺失或被修改。
审计时应明确数据实际去了哪里、谁能读取、保留多久,以及哪些操作没有被记录。不能把“主机在我手里”写成“全部数据和全部操作记录都只在本地且随时完整可查”。
安全的本质
默认防护仍需按部署方式和权限范围核对,不能把它当成自动满足所有安全要求。养虾之前先把笼子扎紧,这个顺序千万不能反。
5. 使用体验:手机操控与数据留存
这一条其实被问得不算多,但我个人觉得它是 OpenClaw 用起来真正”顺手”的关键所在,值得单独拎出来说说。
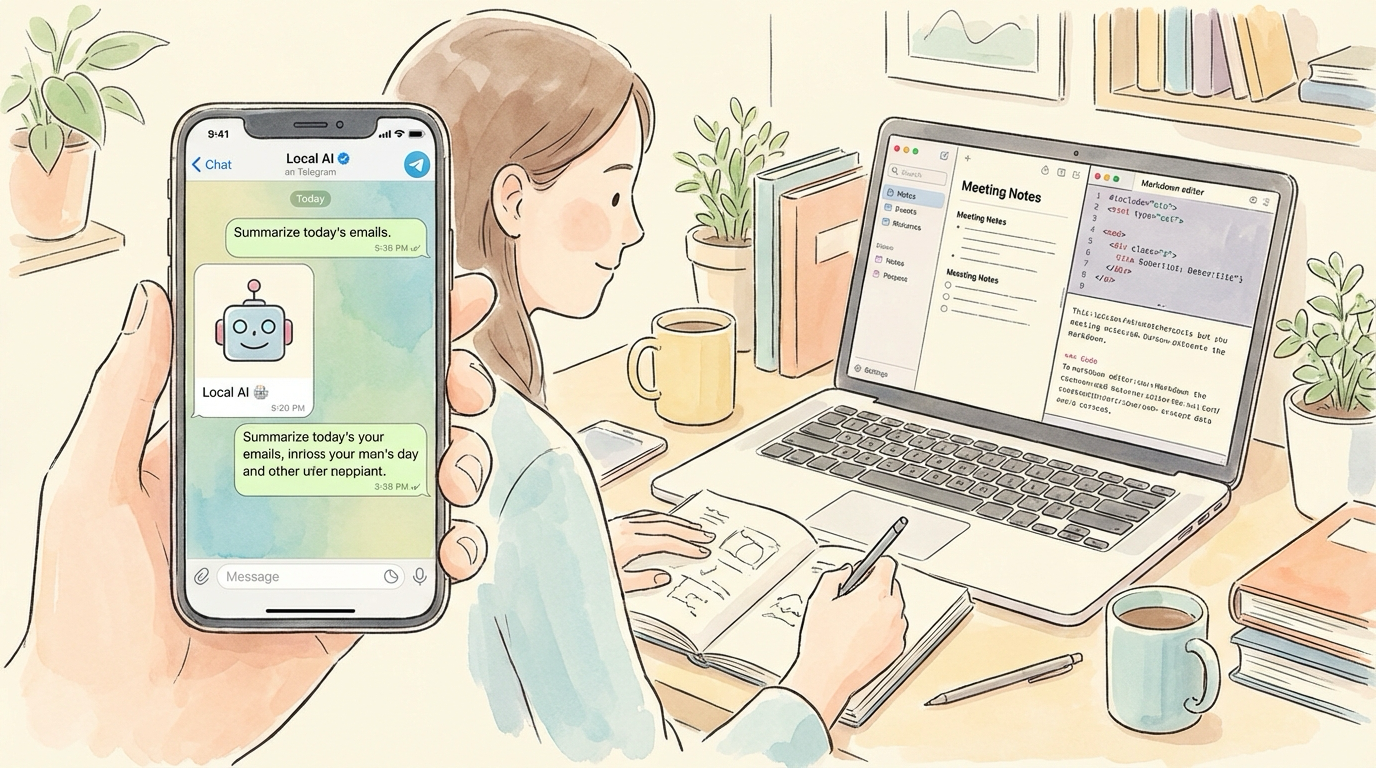
Telegram:一个主 bot + 若干群聊
我的用法是这样:主 bot 用私聊做日常对话、发指令、问问题;不同的 daily task 转发到不同的群——Android 群放技术简报、论文精读、GitHub 动态,Daily 群放日报、周报、系统通知,其他群按需分流。为什么要分群?原因有三个:
- 信息不混杂:技术内容和日常运维日志分开管理,想看哪个类别就进哪个群
- 通知可控:重要的群打开通知提醒,不重要的直接静音,避免信息轰炸
- 协作方便:有些群可以拉同事一起加入,共享信息源
数据落盘到 Obsidian
在我的工作流里,Telegram 是交互与通知入口,重要内容还会写入 Obsidian Vault。这样更便于检索、整理和建立双向链接,但落盘不等于备份,也不保证永不丢失:误删、覆盖、磁盘故障和同步冲突仍可能发生。Telegram 里消息被新内容埋住,也不等于消息自动删除。
写完后检查实际文件与内容完整性,另保独立、可恢复的备份。iCloud/同步服务可能传播误删或冲突;历史版本和备份还应验证能否恢复,不只看同步图标。
我当时的目录结构是这样的:
OpenClaw定时任务/:定时任务输出论文/:原 PDF、翻译与精读笔记Personal-Knowledge/source/:当时记述为 1760 篇的知识库X 文章/:归档的 X 内容
这些是我的目录约定;安装 OpenClaw 不会自动保证每项任务都写到这些位置。
手机随时访问
这一点的重要性比我最初想象的要大得多。出去玩的时候掏出手机打开 Telegram 就能直接给虾哥发指令,跟在电脑前操作没有区别;想看今天的日报打开 Obsidian 手机端文件已经通过 iCloud 同步过来了;遇到紧急情况需要调整任务也不用专门开电脑,手机上就能完成操作。我现在的日常习惯是早上醒来先刷一下 Telegram,看看昨晚虾哥跑了哪些任务、有没有异常,有问题的直接在手机上回复处理。外出的时候也能随时看一眼运行状态,心里有数。
这是我当时使用顺畅的体验,仍依赖主机在线、网络、频道授权和同步完成。涉及本机交互/审批的任务不一定能完全靠手机完成;状态卡片中的 GPT-4、任务数和健康标签只是示意,不是本次或当时运行的证明。敏感 Vault 若要求不离开本机,就不能同时默认同步到 iCloud。
架构总结
Telegram 负责交互,Obsidian Vault 负责内容留存。 常驻执行由 OpenClaw Gateway 和相关服务承担;Vault 不是执行后端。这个组合能让日常操作方便不少,持续可用与数据恢复则依赖运行监控、权限、同步及备份,不能承诺 24/7 永不中断或数据永不丢失。
相关文章
关于我 && 博客
下面是个人的介绍和相关的链接,期望与同行的各位多多交流,三人行,则必有我师!
- 博主个人介绍 :里面有个人的微信和微信群链接。
- 本博客内容导航 :个人博客内容的一个导航。
- 个人整理和搜集的优秀博客文章 - Android 性能优化必知必会 :欢迎大家自荐和推荐 (微信私聊即可)
- Android 性能优化知识星球 :历史社群介绍,2026 年已关闭。
一个人可以走的更快 , 一群人可以走的更远