App 主线程没有按时处理一帧时,先分清它在 Running、Runnable 还是 Sleep;这三种状态对应的下一步调查完全不同。这篇用 Perfetto 的 CPU 调度、频率、空闲状态和采样数据,把「CPU 慢」拆成可核对的现象。
文中的核编号、频率和调度策略都要按目标设备确认。同一条线程运行在小核上,不足以单独证明调度错误。
版本说明(2026-10 核查):保留原案例图,图中设备、核编号和厂商策略不能推广到所有 Android 手机。表结构与 UI 实现按 Perfetto v58.3 核对;调度与调频机制参照 Linux v6.12,不把它当成截图设备的内核版本。Performance Hint 另标 API 31 起的接口边界。
本文目录
- Perfetto 系列文章
- Perfetto 中的 CPU 信息概览
- 抓取 CPU 信息所需要的 Trace Config
- CPU 核心架构:big.LITTLE
- CPU 调度
- CPU Frequency (CPU 频率) 深度解析
- CPU Profiling、火焰图与符号化
- Linux 内核调度策略:选核与迁移
- 实战与 SQL
- 总结
Perfetto 系列文章
- Android Perfetto 系列目录
- Android Perfetto 系列 1:Perfetto 工具简介
- Android Perfetto 系列 2:Perfetto Trace 抓取
- Android Perfetto 系列 3:熟悉 Perfetto View
- Android Perfetto 系列 4:使用命令行在本地打开超大 Trace
- Android Perfetto 系列 5:Android App 基于 Choreographer 的渲染流程
- Android Perfetto 系列 6:为什么是 120Hz?高刷新率的优势与挑战
- Android Perfetto 系列 7:MainThread 和 RenderThread 解读
- Android Perfetto 系列 8:深入理解 Vsync 机制与性能分析
- Android Perfetto 系列 9:CPU 信息解读
- Android Perfetto 系列 10:Binder 调度与锁竞争
- Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测
- Android Perfetto 系列 12:Trace 数据流与丢失排查
- Android Perfetto 系列 13:Perfetto SDK、Track Event 与 App 现场 Trace
- Android Perfetto 系列 14:heapprofd 与内存 Profiling
- Android Perfetto 系列 15:Boot Trace、长时间现场 Trace 与偶发问题抓取
- Android Perfetto 系列 16:GPU、Power Counters 与硬件瓶颈分析
- Android Perfetto 系列 17:专项场景自动化、问题清单与平台体系
- Android Perfetto 系列 18:响应速度实战,从输入事件到首帧反馈
- 视频(B站) - Android Perfetto 基础和案例分享
- 视频(B站) - Android Perfetto 分享 - 出图类型分享:AOSP、WebView、Flutter + OEM 系统优化分享
Perfetto 中的 CPU 信息概览
在 Perfetto UI 中,CPU 相关的信息通常分组置于顶部,是性能分析的起点。通常要同时看以下三类信息,频率与 idle 也可能叠在同一轨道:
- CPU Scheduling (CPU 调度): 显示在每个时间点,各个 CPU 核心上正在执行的线程。
- CPU Frequency (CPU 频率): 显示每个 CPU 核心或核心簇的频率变化情况。
- CPU Idle (CPU 空闲状态): 显示每个 CPU 核心进入的低功耗状态 (C-States)。
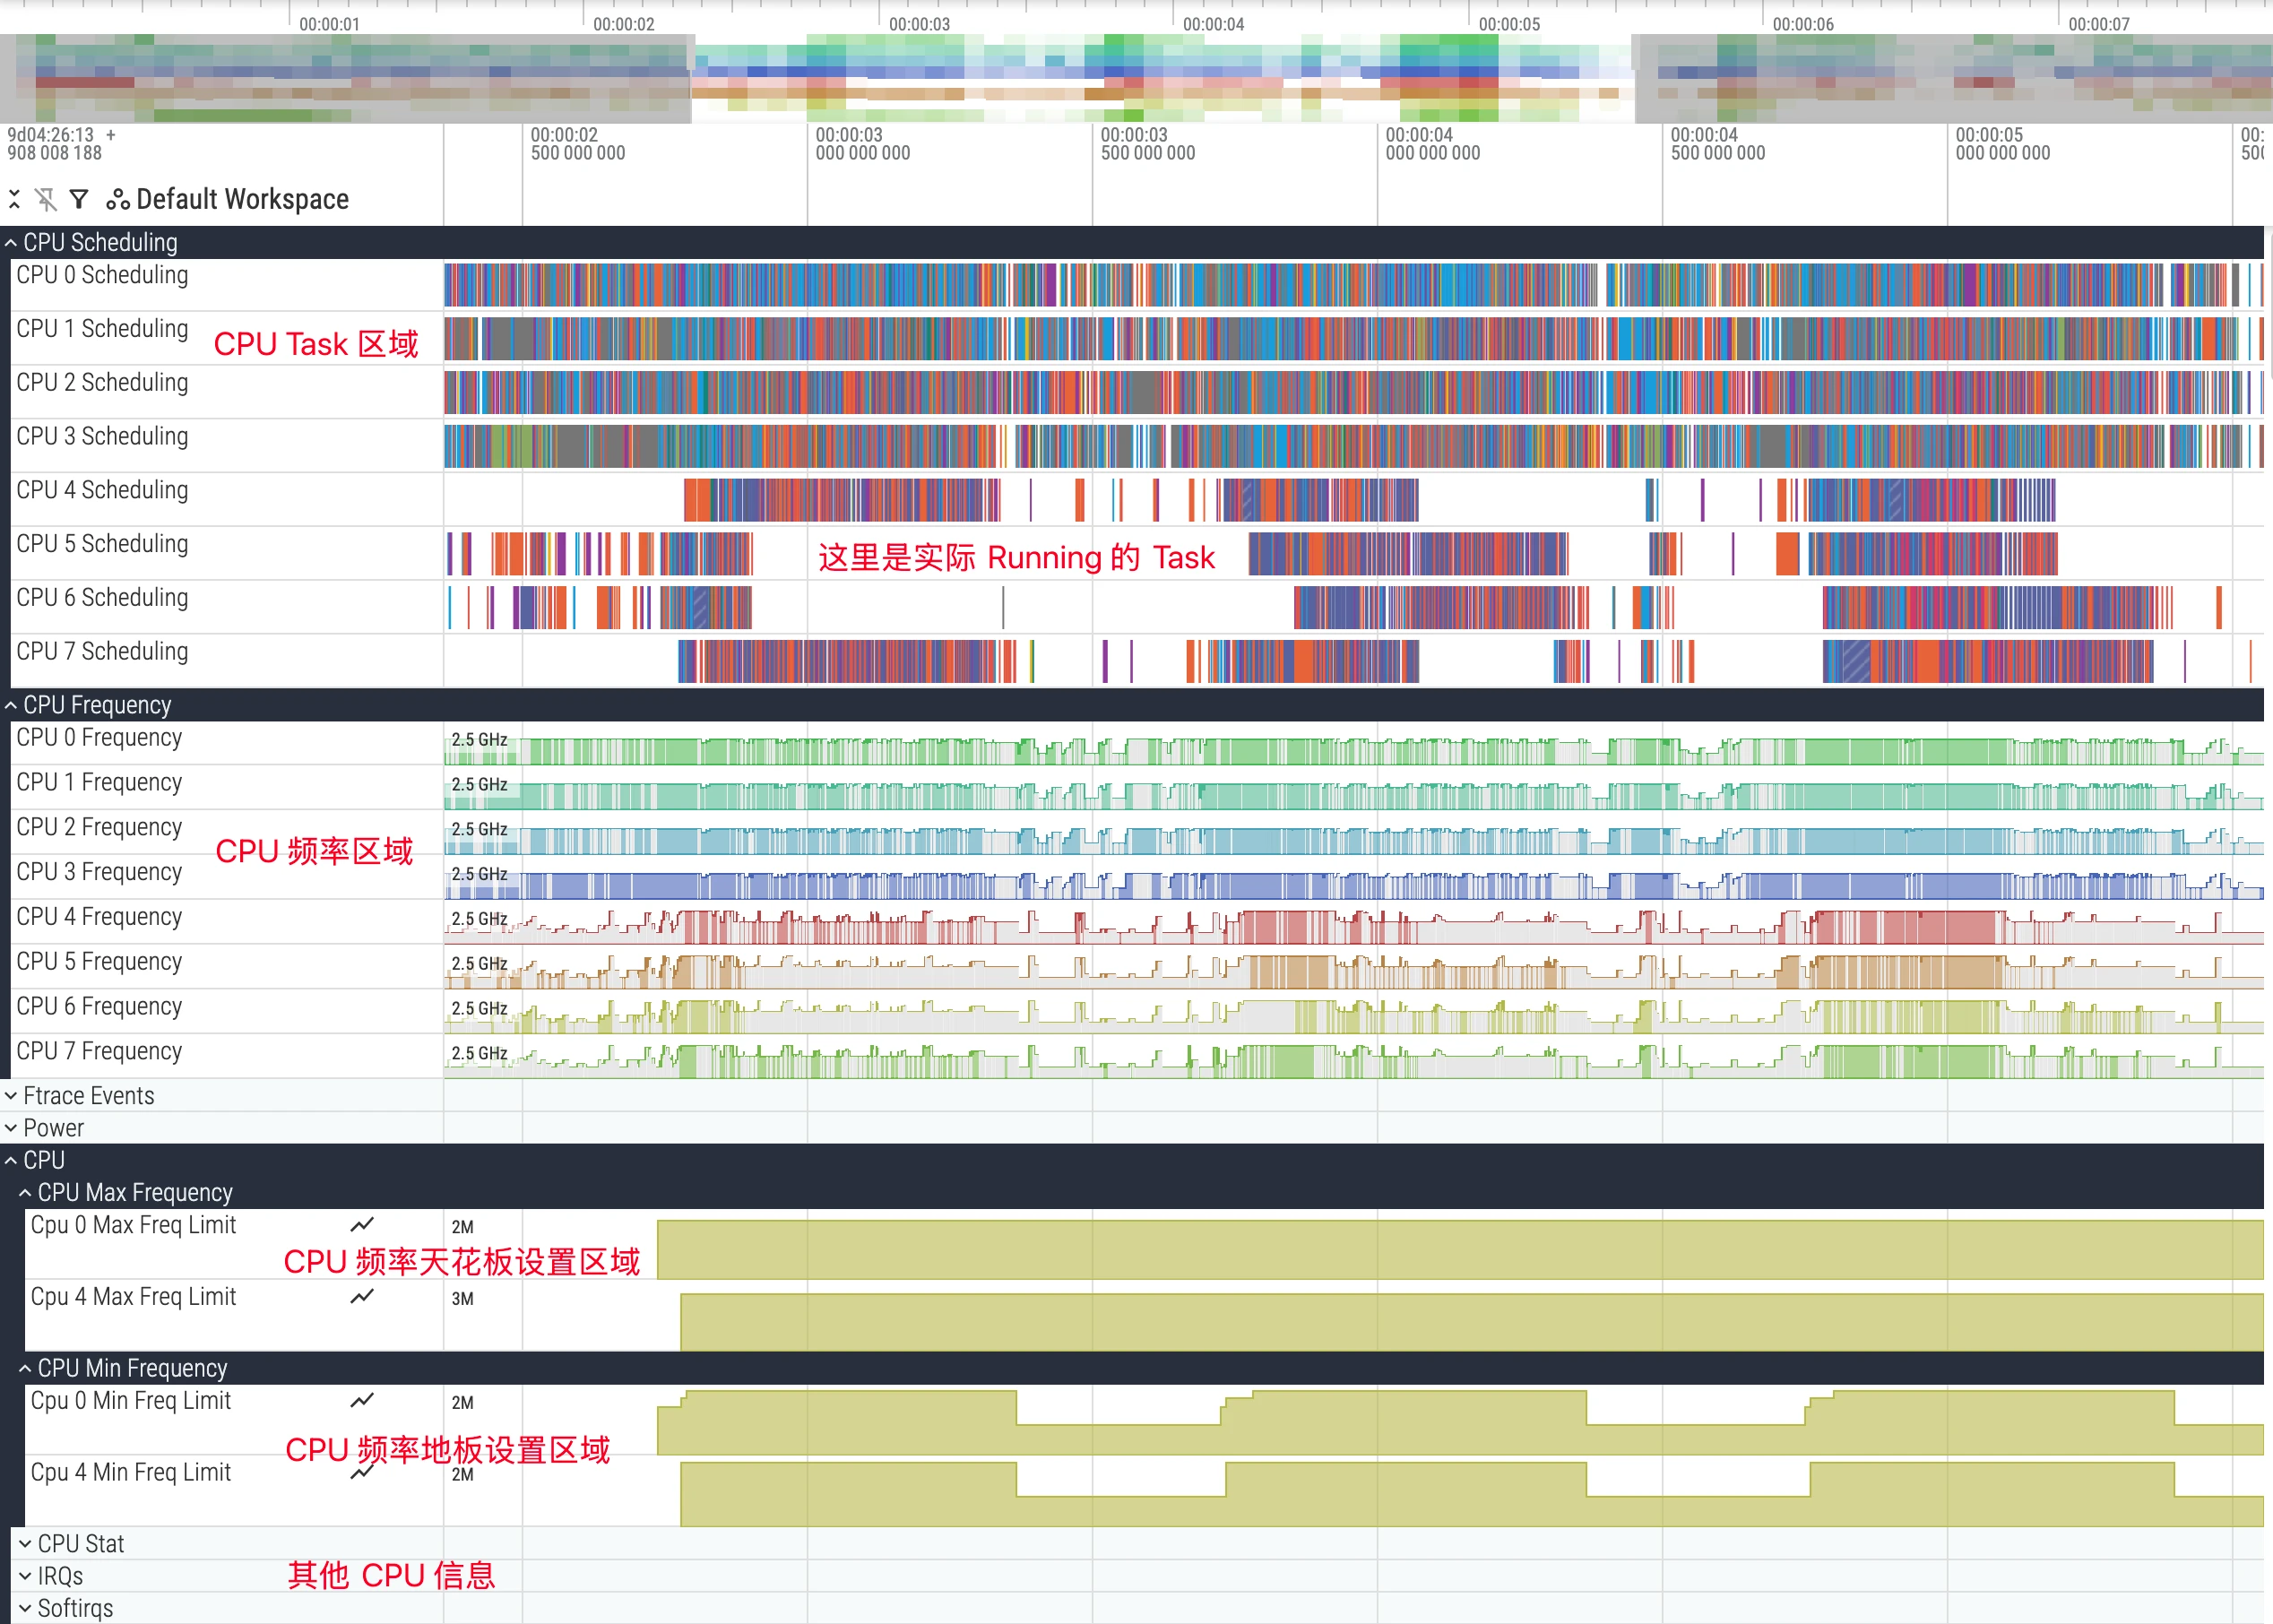
把 CPU 轨道和目标线程放在同一时间窗口,可以先回答:
- 应用主线程为何没有执行?是否被其他线程抢占?
- 某个任务执行缓慢的原因是什么?是否被调度到了低性能核心?
- 在特定场景下,CPU 频率是否受限?
- 应用转后台后 CPU 是否进入 idle?整机是否 suspend 需另看 suspend 事件。
抓取 CPU 信息所需要的 Trace Config
下面是 CPU 调度、唤醒和频率采集的 textproto 数据源片段,参考 Perfetto Android 分析示例。它不是 YAML,也不是完整录制配置;需要与 buffers、duration_ms 等录制设置合并。事件和符号权限取决于设备内核、构建与 Perfetto 版本。
1 | data_sources { |
这个片段不包含 syscall、CPU callstack sampling 或厂商的 Min/Max Frequency Limit 事件。第一张图出现这些额外轨道,不代表用此片段就能全部录到。cpufreq_period_ms: 250 是轮询间隔,不会捕捉两次读取之间的每次变频;与频率变化事件结合使用。
CPU 核心架构:big.LITTLE
分析调度之前,先确认设备拓扑。手机 SoC 可以使用不同容量的核簇,但不一定都有传统的 LITTLE 微架构;“小核”“大核”有时只是同一芯片内的相对称呼。不能从核心编号、频率上限或截图里的标注直接推导型号。
- 小核(LITTLE):传统异构设计中偏向低功耗的核心;不代表后台线程只能在这里运行。
- 大核(big):偏向更高性能,适合较重负载;性能与能耗仍取决于具体任务。
- 超大核(Prime):部分芯片的最高性能核心或核心组,不保证只有一个。
Perfetto 的 CPU 编号通常从 0 开始,编号不等于性能排序。以下三图分别保留原有的 4+4、4+3+1、5+2 分组标注,属于特定截图示意,不能据此认定具体芯片或套用到另一设备。
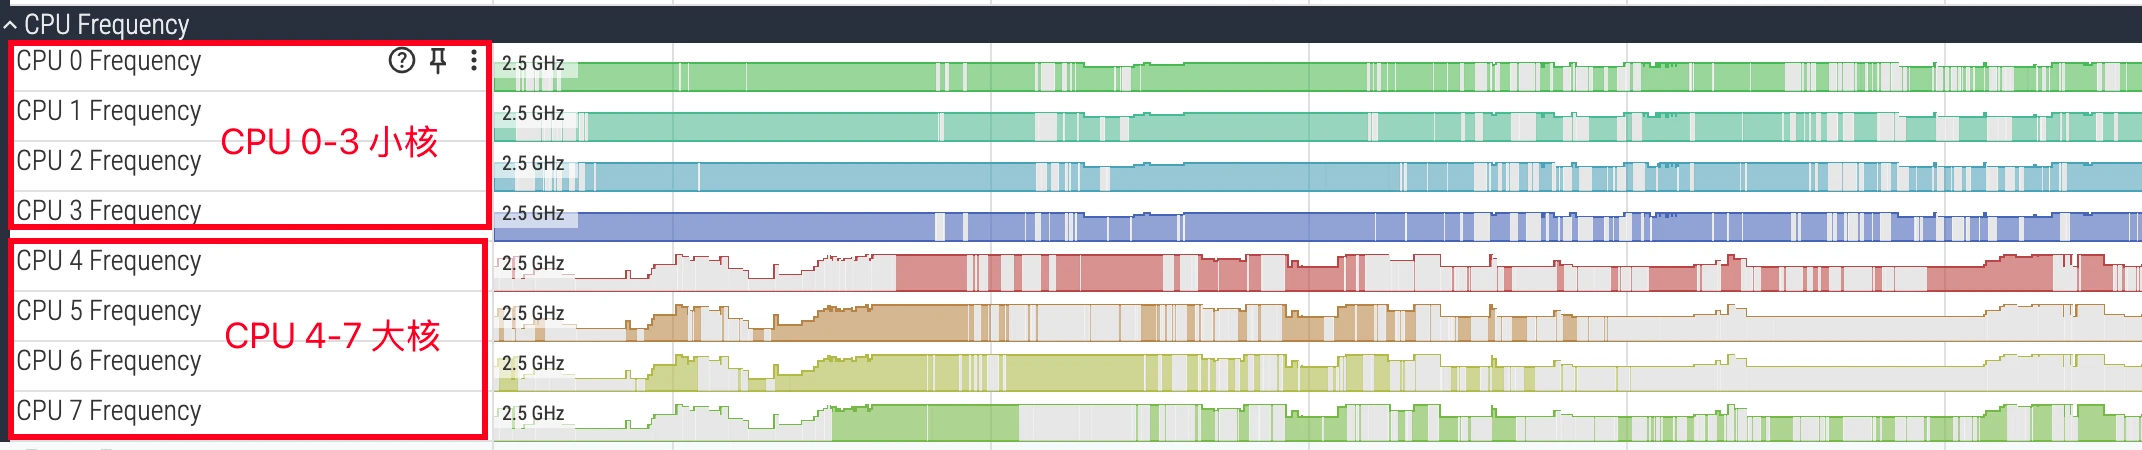
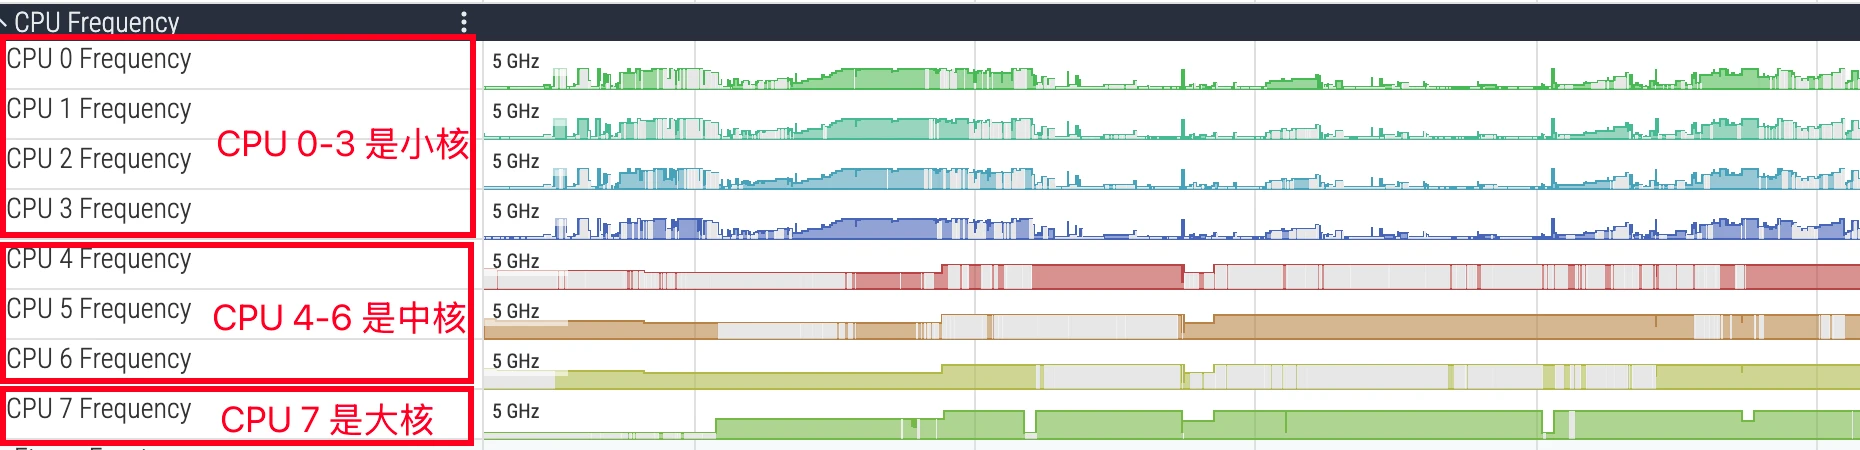
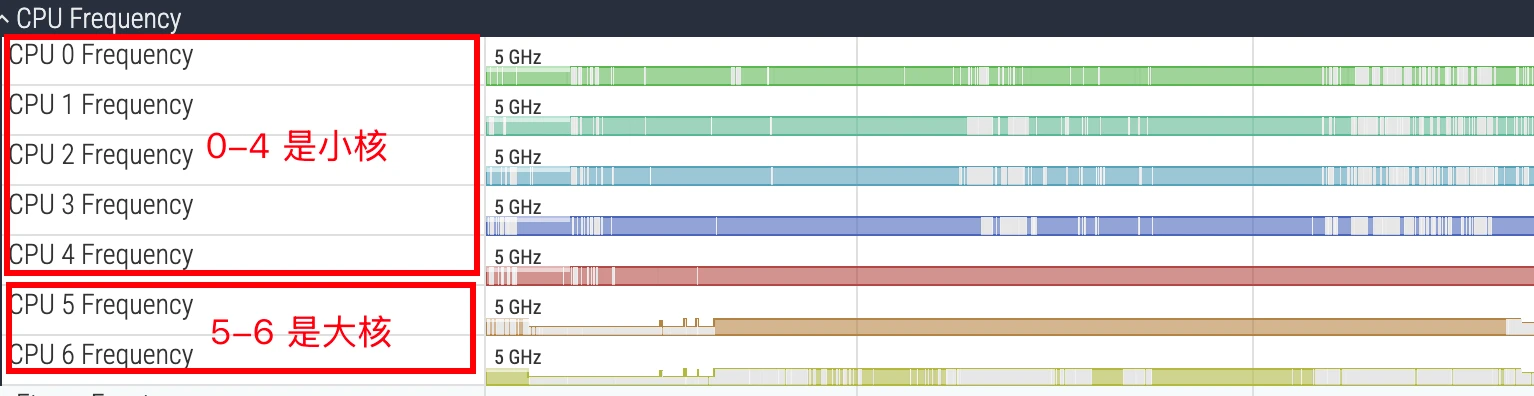
从设备规格及 /sys/devices/system/cpu/ 的 topology、capacity、cpufreq policy 信息核对。policy 分组说明共享调频控制,也不必等同微架构分组。
CPU 调度
CPU Scheduling 轨道是最常用且最重要的部分,它展示 Linux 内核调度器产生的运行区间,不直接记录完整的选核决策。其数据来源于内核 ftrace 中的 sched/sched_switch 事件。
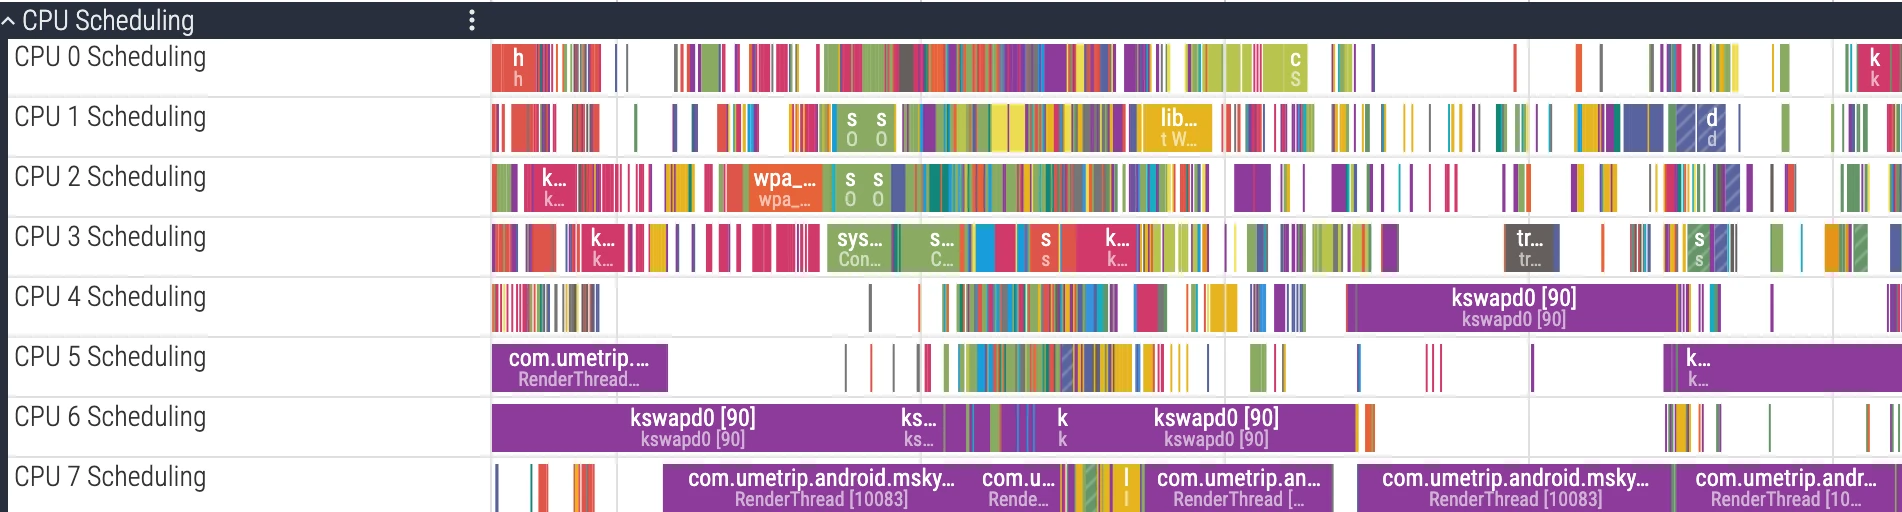
每个 CPU 核心对应一行独立的轨迹。轨道上的不同色块,代表了在该时间片上,特定线程正在该 CPU 核心上运行。
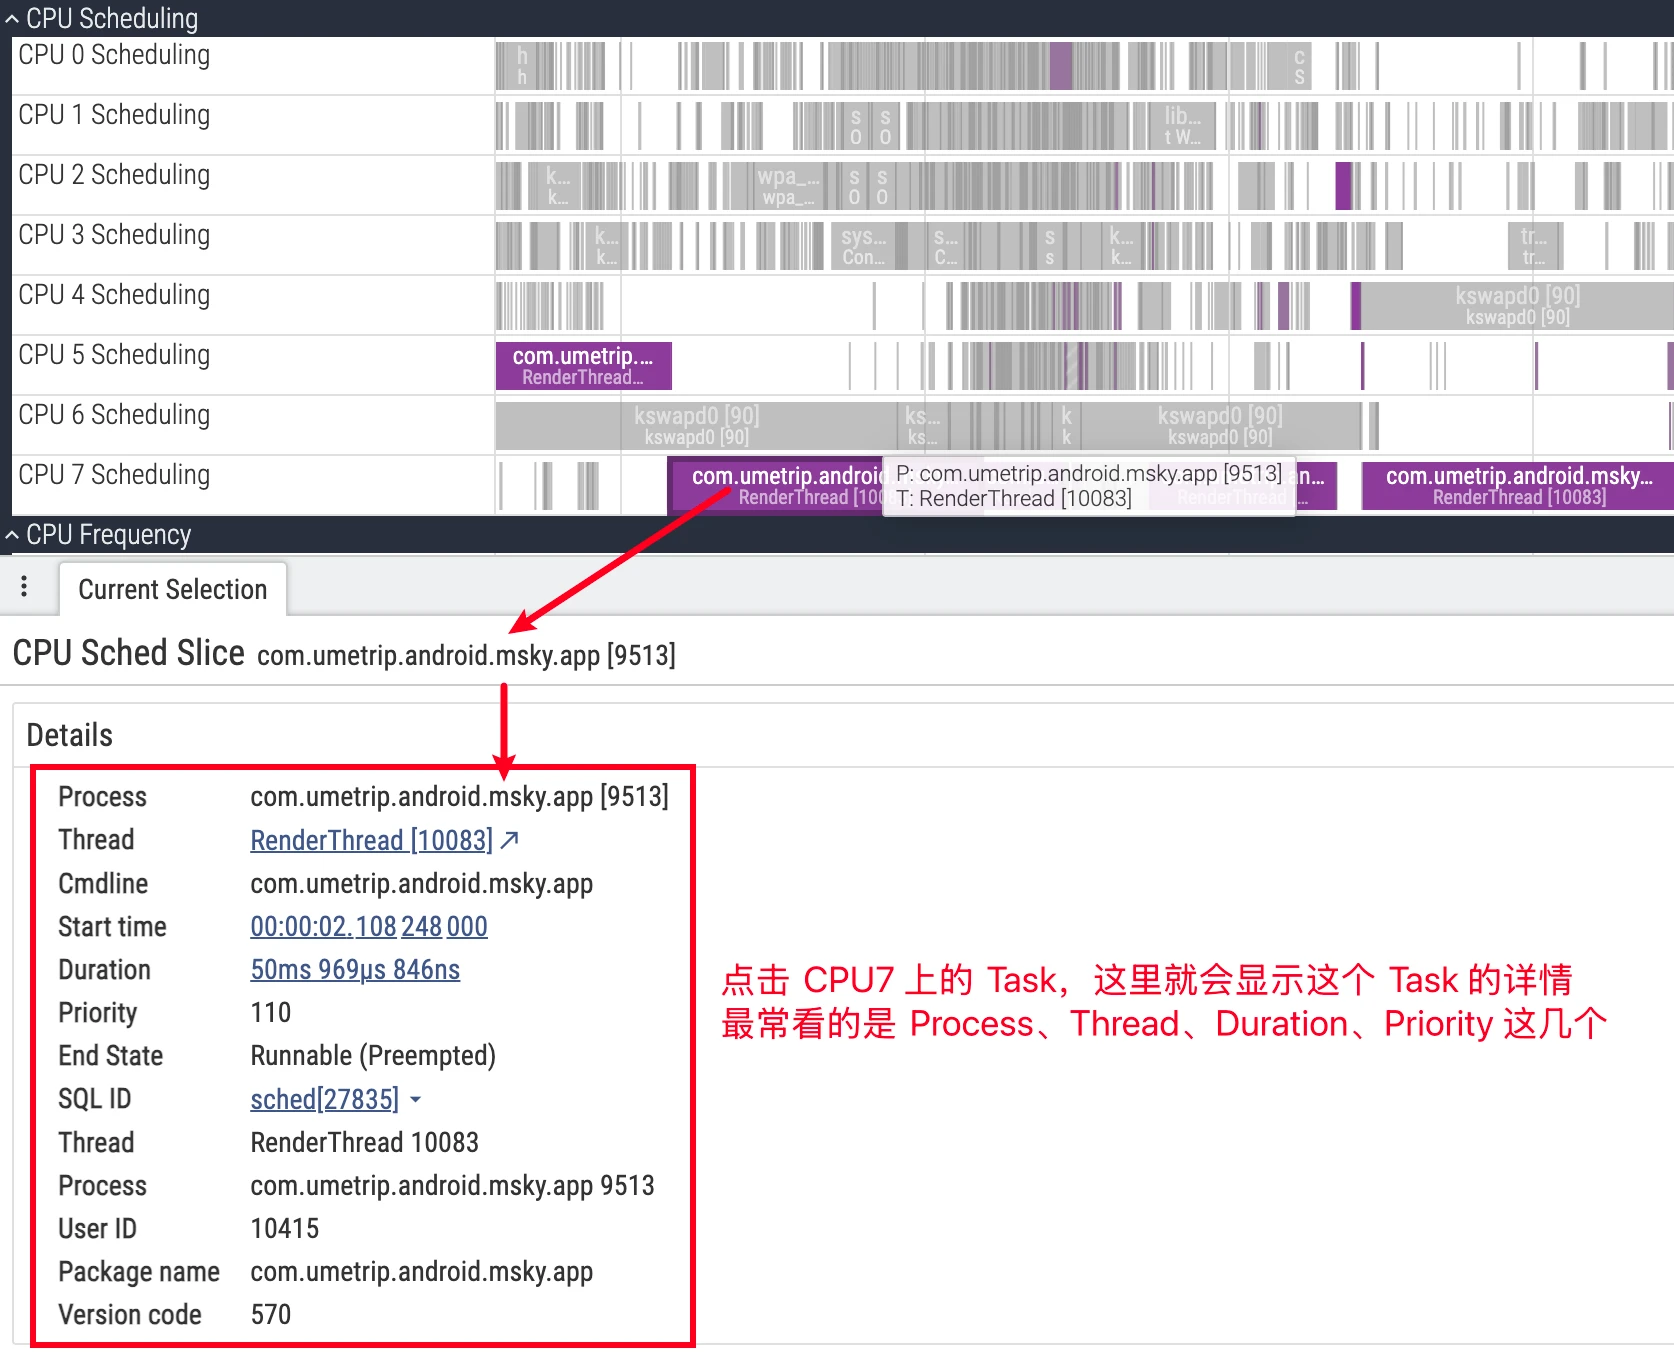
- UI 细节:点击 CPU 切片,详情面板会显示该次调度的
cpu、end_state、priority、所属process/thread等;向下展开进程还能看到每个线程的独立轨道,便于跟踪单个线程的状态演化(参考 官方文档)。
线程状态深度解析
理解 Linux 的线程状态是进行性能优化的前提。在 Perfetto 中,选中线程状态切片,可在详情面板读该区间的状态;面板名称随 UI 版本变化。这些状态信息来源于 Perfetto 解析得到的 thread_state 表。
Running (绿色)
状态定义:绿色代表线程正在 CPU 上执行代码。这是从调度事件重建的在核运行区间,可能包含用户态、内核态、忙等和 CPU stall;还可能覆盖未单独扣除的中断处理。
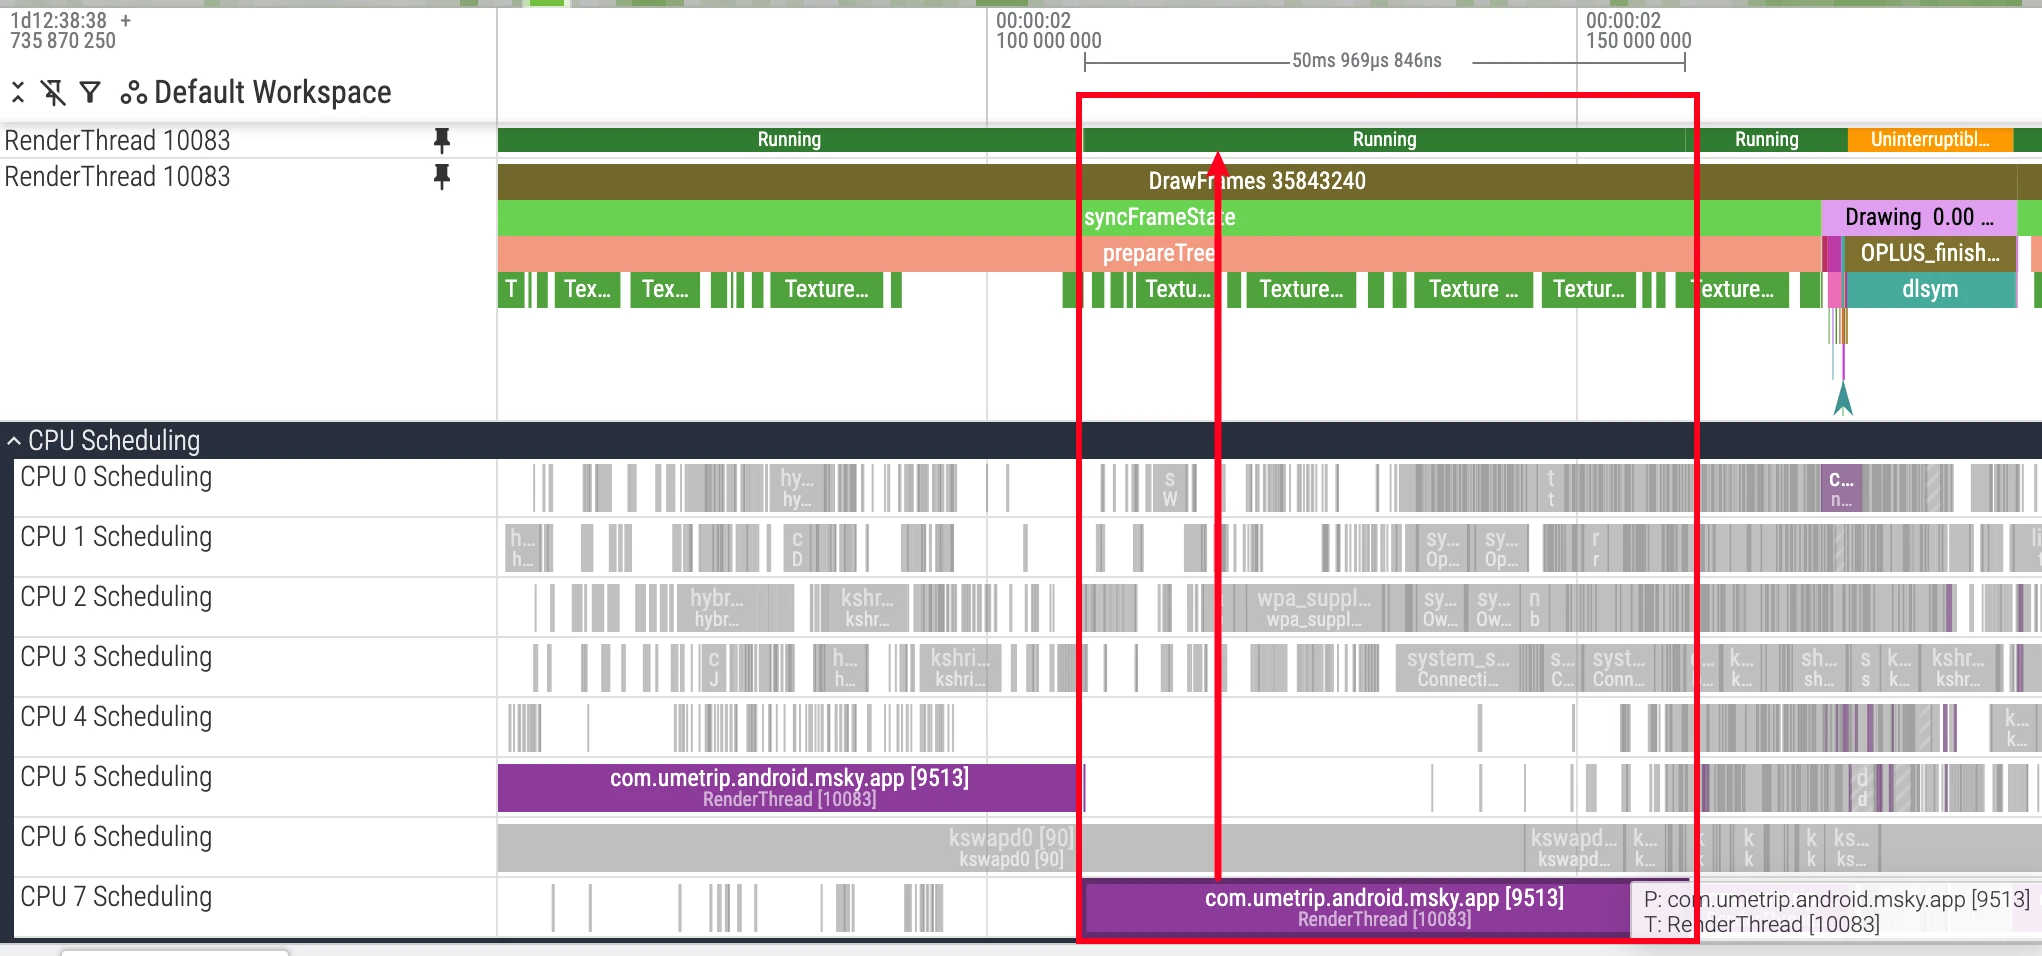
分析要点:
- 执行时长:长时间 Running 说明线程占用了 CPU,但可能是计算、系统调用或忙等。下一步要用采样或代码埋点定位具体工作。
- 运行核心:结合 CPU 的核心架构(例如 big.LITTLE)进行分析。一个计算密集型任务是否被调度到了预期的性能核心(大核)上,是评估调度策略是否合理的重要依据。
- 运行频率:线程的执行速度也可能受频率限制影响;影响大小取决于计算、访存和等待的比例。因此需要结合
CPU Frequency轨道进行综合分析。
R (Runnable / 可运行)
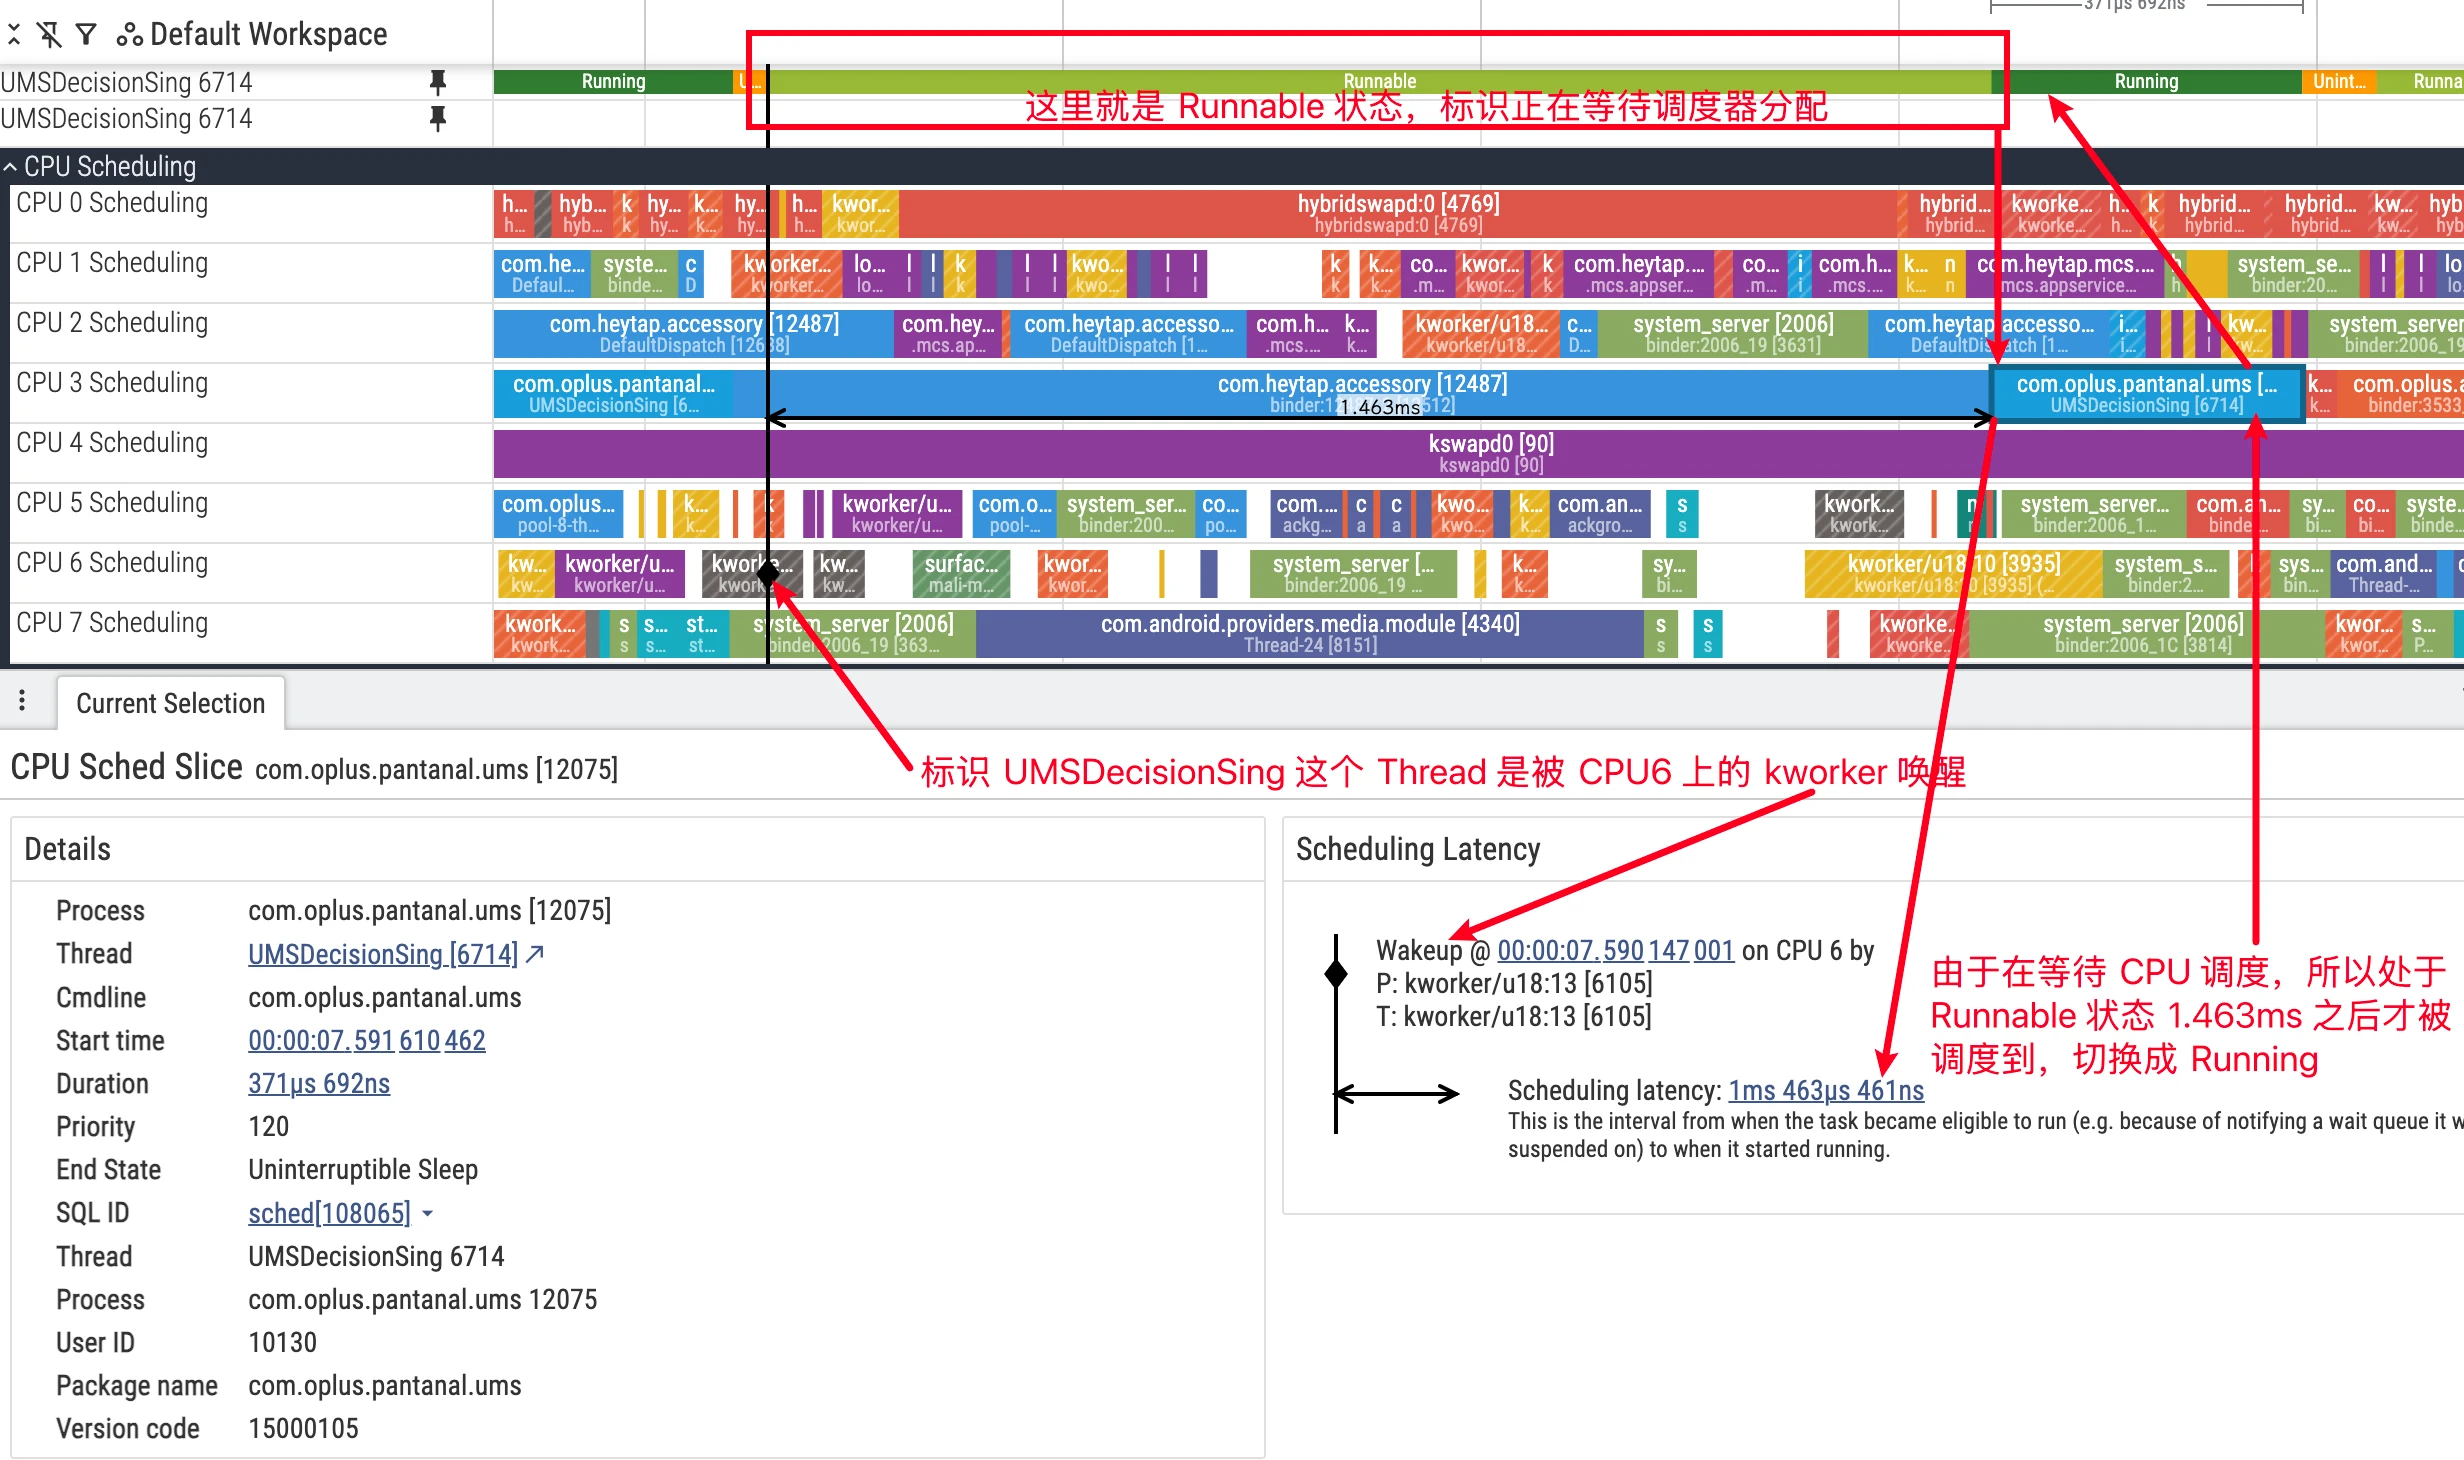
状态定义:线程已可运行,但尚未在 CPU 上执行;它仍受 affinity、cpuset、调度类及带宽限制等约束。在 Perfetto 的线程私有轨道中,Runnable 状态通常以浅绿色或白色条显示。
分析要点:
Runnable与卡顿:UI 线程长时间处于 Runnable,说明已经可以运行却尚未拿到 CPU。若它与晚帧时间窗口重合,才进一步判断这段排队对帧截止时间的影响。
Runnable 的三种类型:
仔细观察会发现,线程进入 Runnable 状态的“前身”各不相同。根据内核的调度时机,我们可以将其分为三种情况:
从睡眠中唤醒-Wake-up:这是最常见的一种。线程在相应等待条件满足时从
S或D唤醒;可中断等待还可能因信号结束,带超时的等待也可能到期。之后进入Runnable状态,等待被调度器选中执行。运行后仍可运行:线程从 Running 被换下后保持 Runnable,
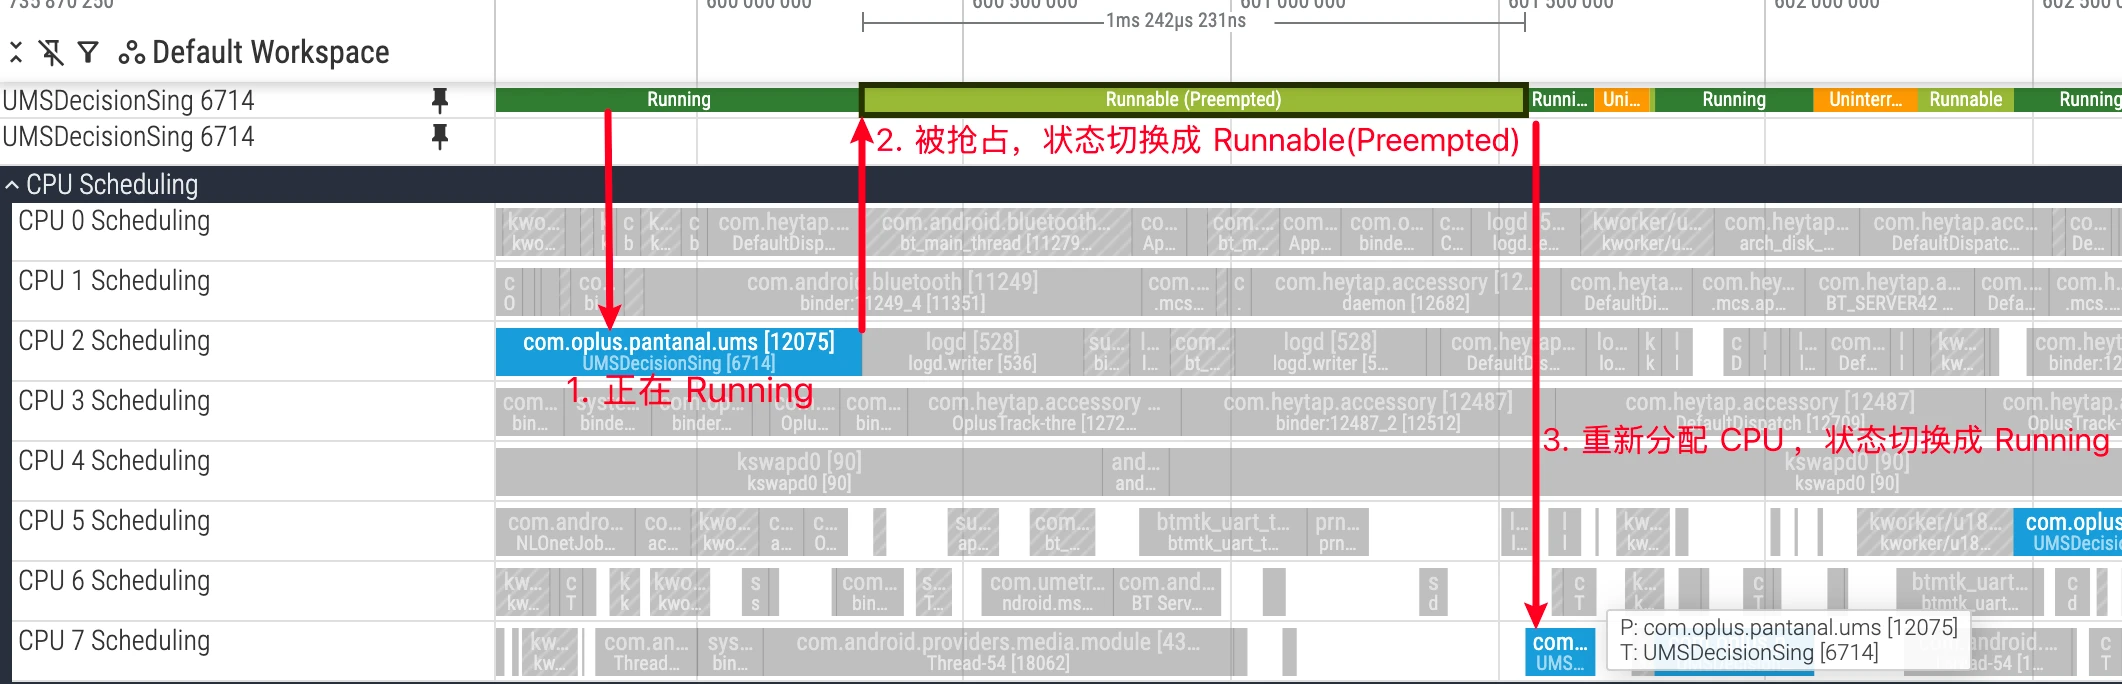
sched_switch中的prev_state可记为R。单看这个状态不足以还原具体调度原因。被抢占:
prev_state为R+时,Perfetto 展示为Runnable (Preempted)。这说明线程被换下时仍可运行,不能据此断定一定发生在内核态,也不能直接归因于某个高优先级线程。
出现大量 Runnable (Preempted) 时,对齐同一 CPU 上接着运行的线程、优先级和系统负载,才知道是竞争、时间片还是其他调度条件。改线程优先级之前,还要确认它是否属于用户可感知的关键路径。
S (Sleep / 可中断睡眠)
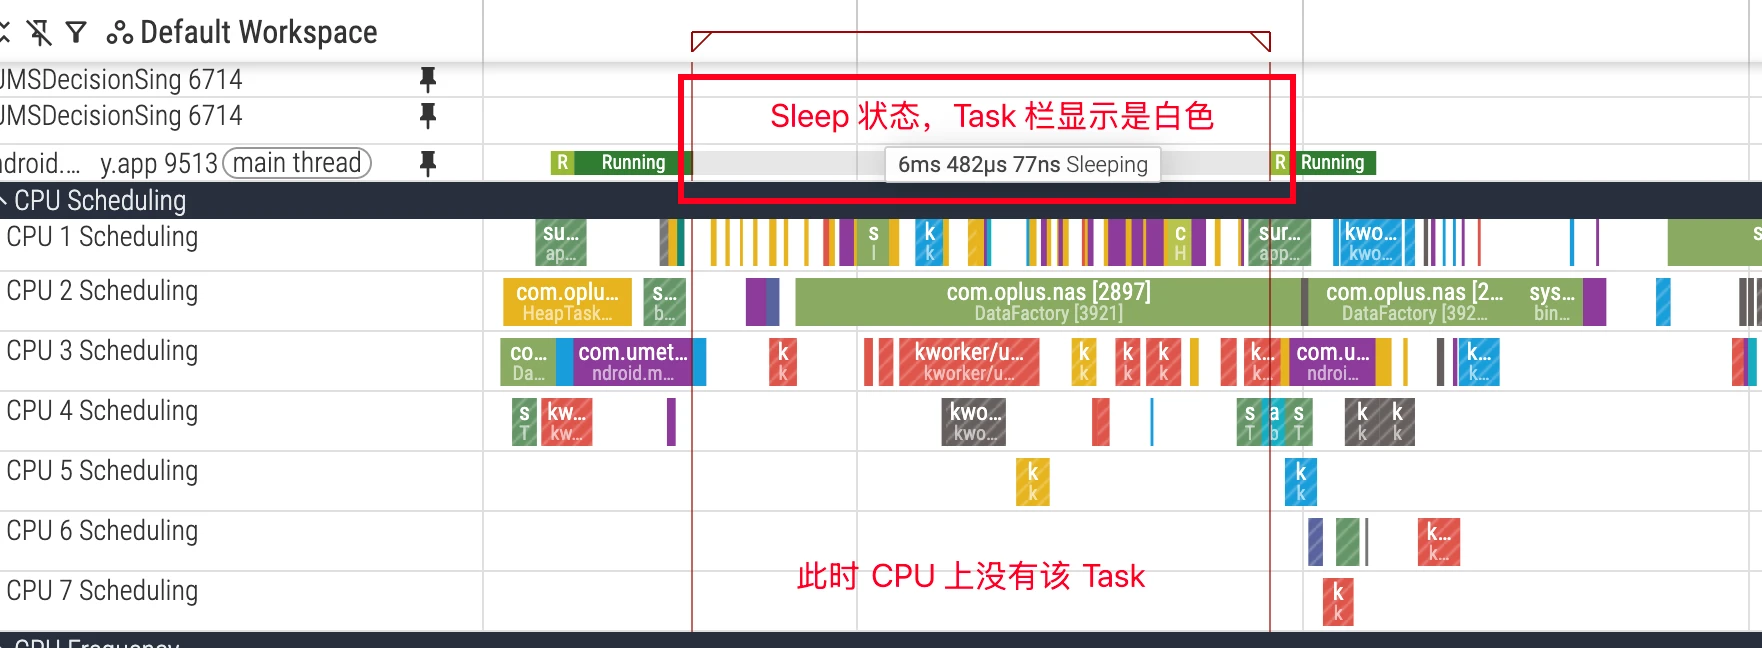
状态定义:线程因等待某个事件而进入睡眠,可以被信号中断。这是最常见的睡眠状态,通常情况下是良性的,因为它在等待期间不消耗 CPU 资源。
分析要点:
- 等待的资源:如果关键线程(如 UI 线程)在待完成工作的关键路径上睡眠过久,才需分析是否影响响应。空闲等待本身不是性能问题。常见的等待原因包括:
- 锁竞争:等待锁或条件变量,底层可能使用 futex;Java monitor、native mutex 与 futex 不是同一种抽象。
- Binder 通信:等待另一个进程通过 Binder 调用返回结果。
- I/O 操作:等待 fd 就绪,例如
epoll_wait;也可能是 Looper 空闲等待,并非必然在等网络。 - 显式休眠:代码中调用了
Thread.sleep()或Object.wait()。
- 依赖分析:在 Perfetto 中,相关唤醒事件可用时,选中后续 CPU slice 可查看唤醒来源,这有助于快速定位线程间的依赖关系。结合函数调用栈,可以进一步定位导致睡眠的具体代码。
D (Uninterruptible Sleep / 不可中断睡眠)
状态定义:D 表示不可中断睡眠,常见于内核等待路径,但不只对应硬件 I/O。Perfetto 的颜色会随轨道和主题变化,排查时以状态字段、io_wait 和 blocked_function 为准。
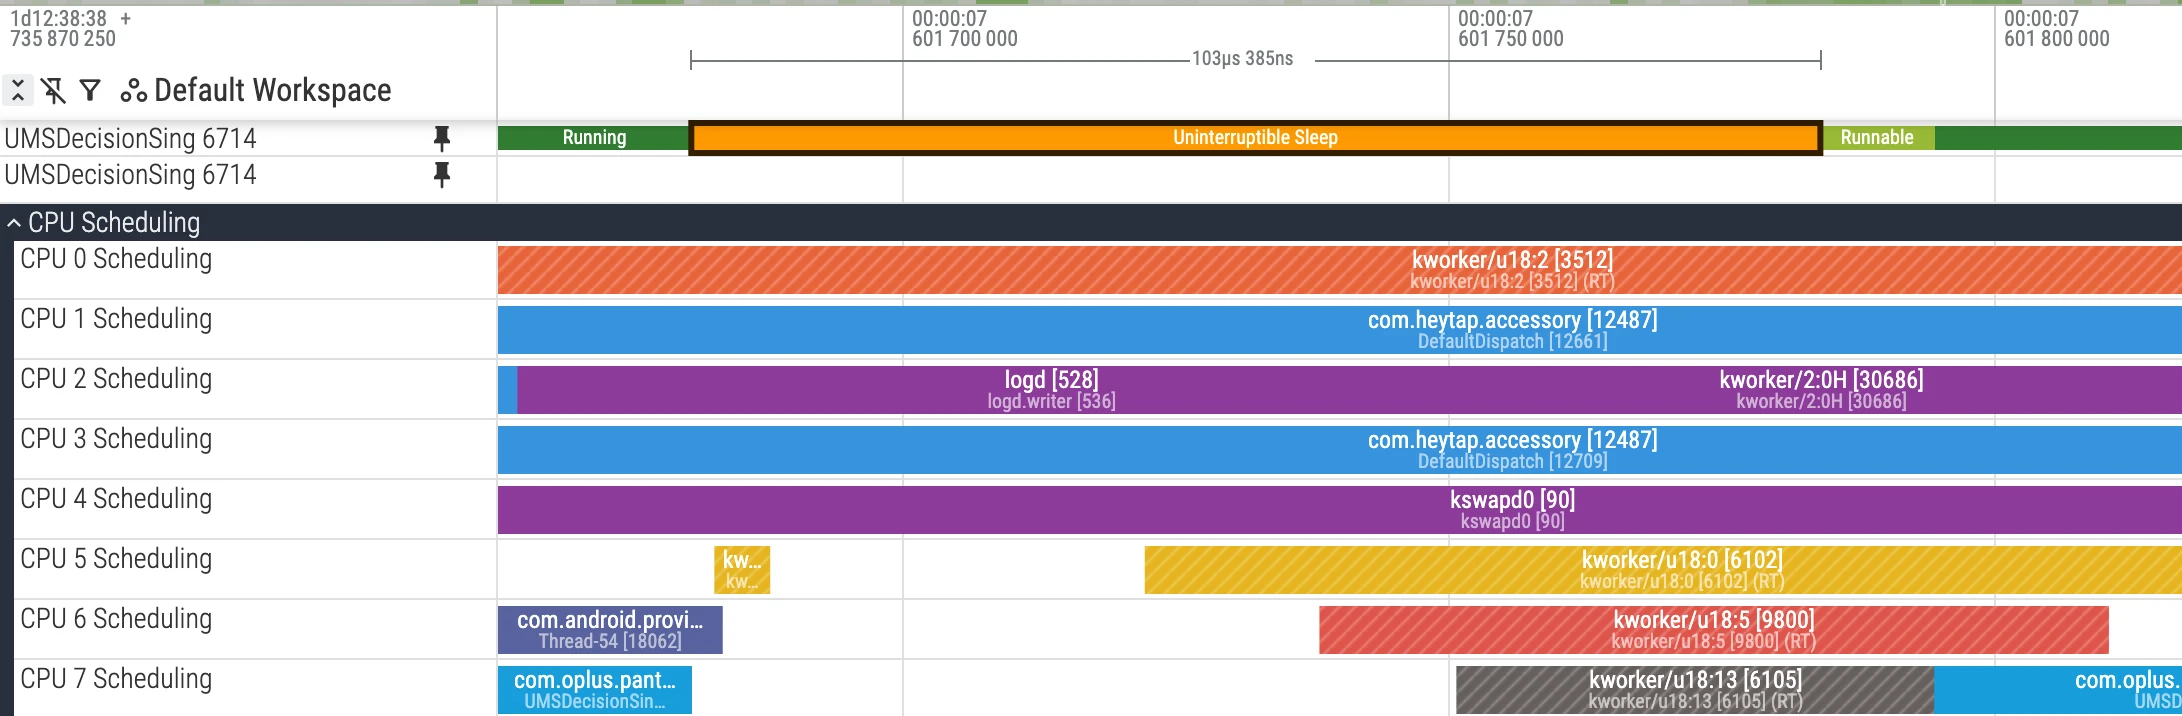
分析要点:
- 关键路径上的等待:
D等待仍可由等待条件完成而唤醒,不是“无法响应任何事件”。若阻塞关键路径且超过相应超时,可能参与 ANR;图中约 103µs 的一次等待不能证明 ANR。 - 常见原因:
- 磁盘 I/O:频繁或单次大量的文件读写操作。
- 内存压力:回收或换页可能延长内核等待;是否涉及存储 I/O 要继续查具体事件和设备实现。
- 内核驱动问题:部分内核驱动的实现缺陷也可能导致线程陷入
D状态。
- 排查方向:
io_wait标记是重要线索,但不能单独给出文件或设备原因。结合blocked_function、I/O 事件和目标线程调用栈继续定位。
唤醒关系分析
线程间的依赖关系是性能分析中的一个难点。一个线程长时间 Sleep,关键在于找出它在“等谁”。Perfetto 提供了强大的唤醒关系可视化功能。
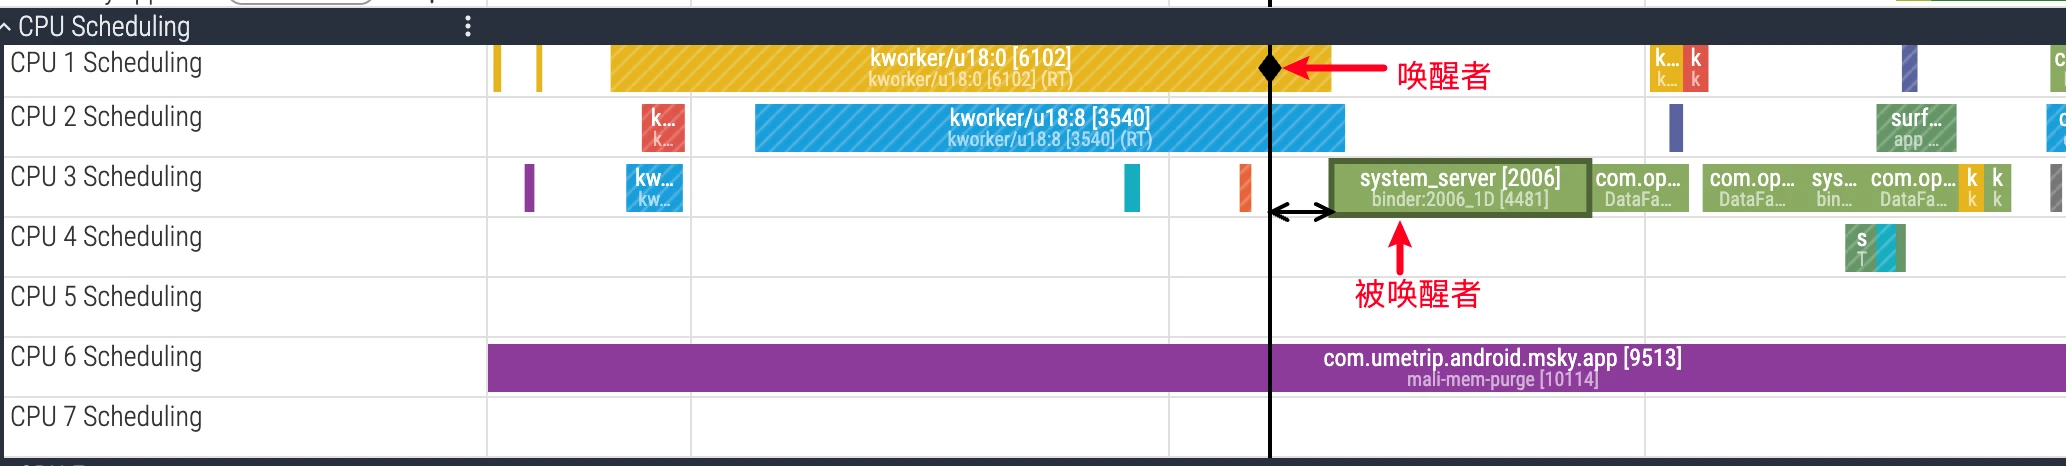
- UI 操作:在 Perfetto 的 CPU 区域中,用鼠标左键单击选中一个处于
Running状态的线程 Task 。在采到可关联的唤醒事件时,Perfetto 可以绘制一条从“唤醒者”到“被唤醒者”的依赖箭头,并高亮显示唤醒源所在的线程切片。 - 底层原理:Perfetto v58.3 的
ParseSchedWaking用sched_waking的当前执行上下文和目标 pid 记录唤醒关系。中断上下文、缺事件和 trace 边界会影响归因;被中断时的当前线程不一定是业务上完成资源的线程。
唤醒关系能指出一个线程何时让另一个线程变为 Runnable。Binder 调用、锁等待和资源归属还需要各自的 trace 事件或调用栈核对;一条唤醒箭头不足以还原完整调用链。
调度唤醒与延迟分析
线程被唤醒后,仍可能等待一段时间才开始执行。Java Object.notify() 与内核 wakeup 不能逐次等同:等待者还要重新取得 monitor,可能再次阻塞,也可能因超时或伪唤醒而返回。
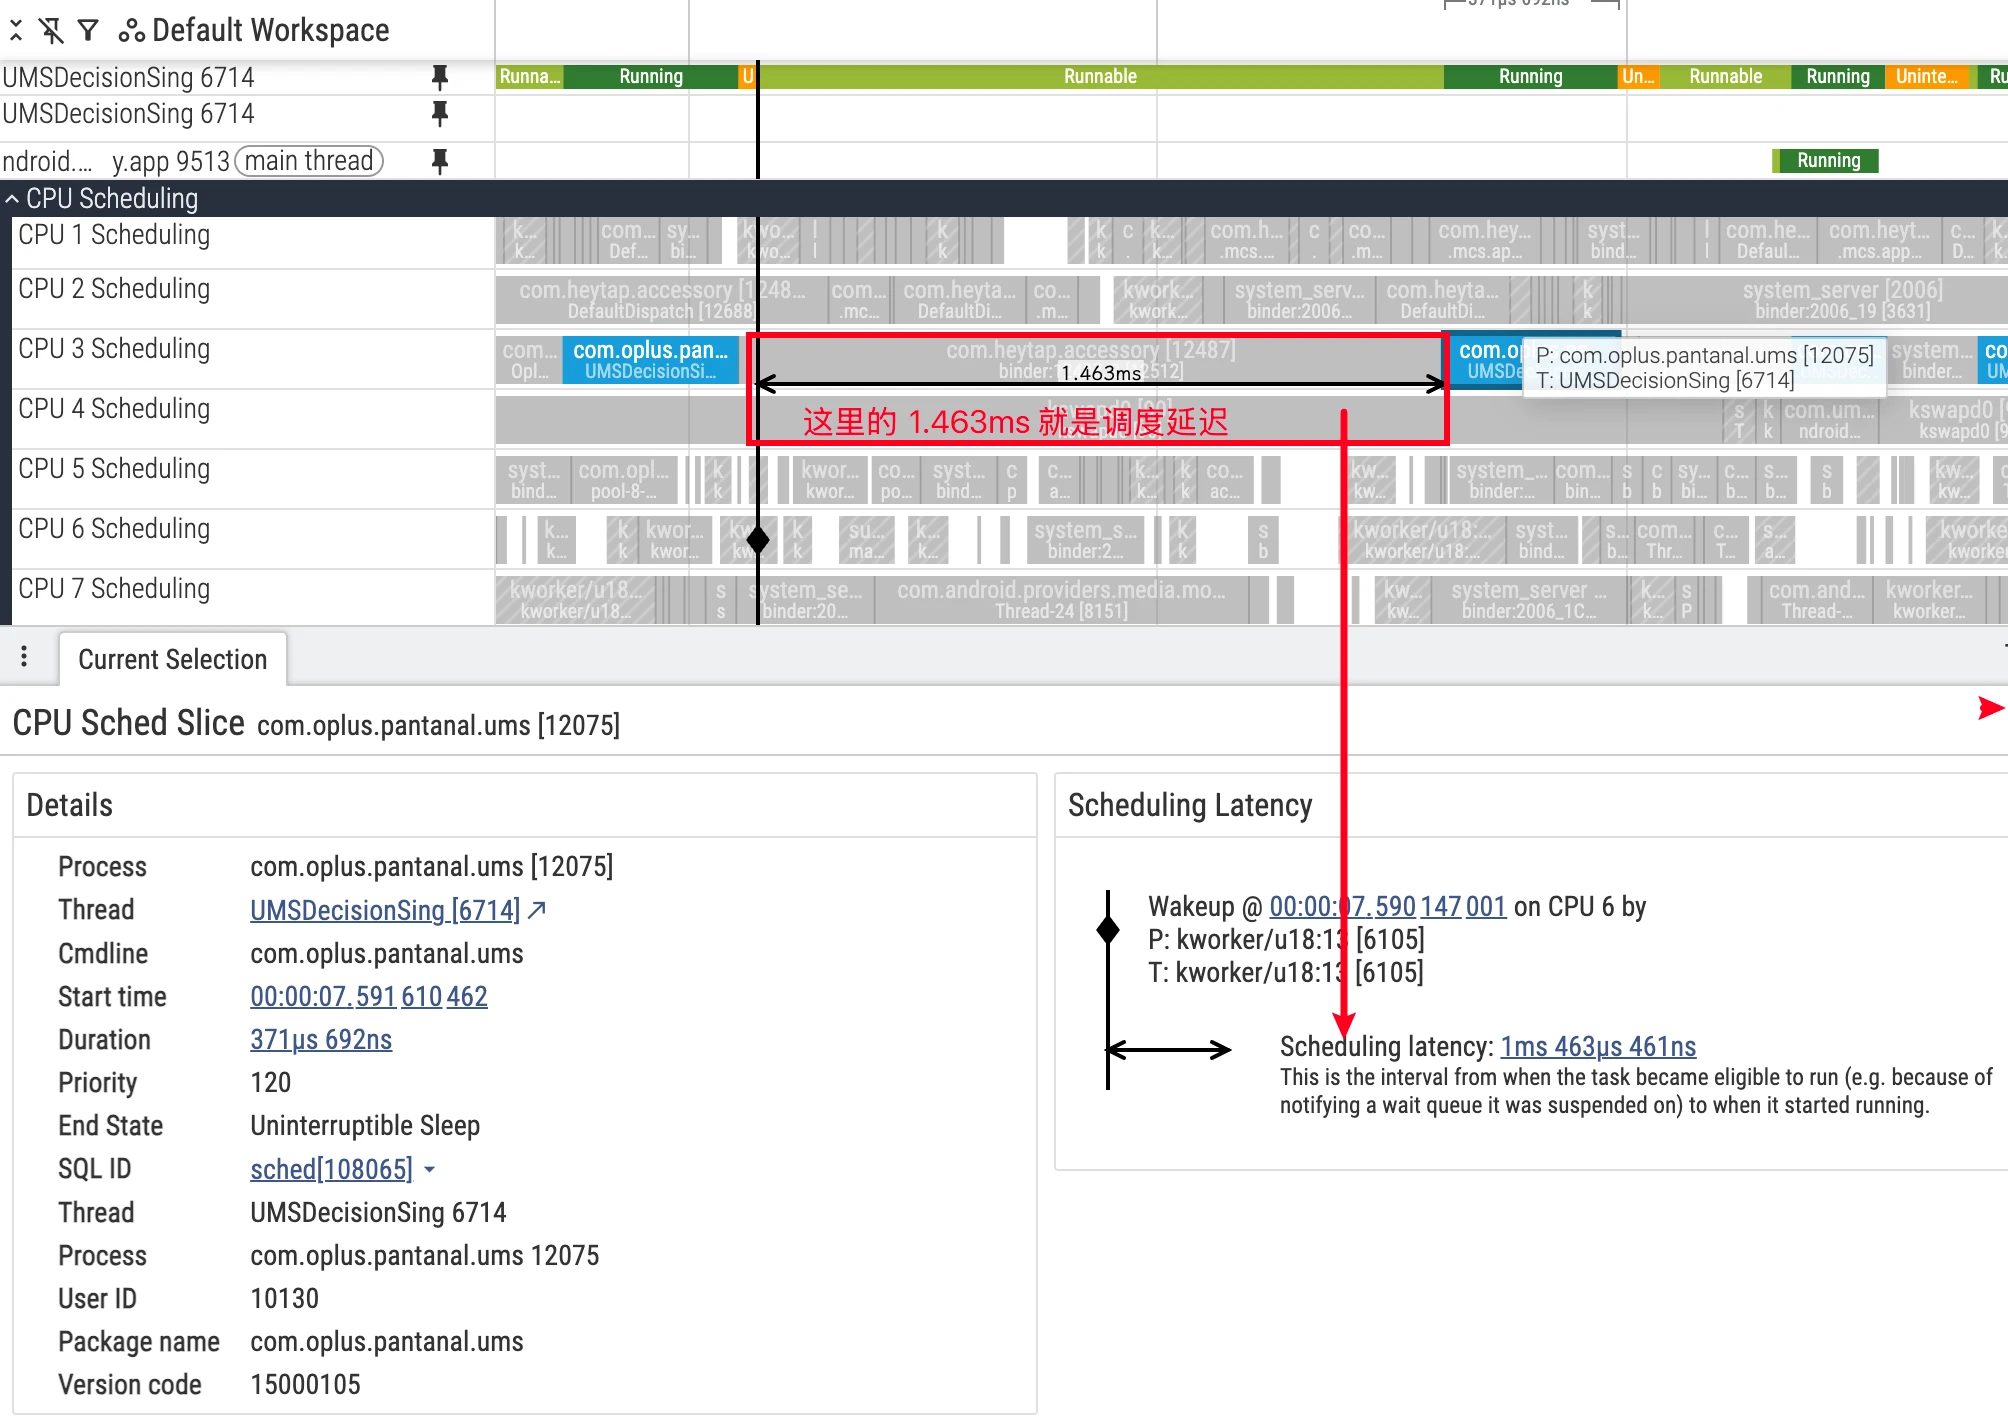
图中 UMSDecisionSing 的唤醒来源是 CPU6 上的 kworker,之后在 CPU3 运行,标出的约 1.463ms 是唤醒到开始执行的延迟。它不能单独证明是优先级、迁核还是带宽限制造成的。
- 在
thread_state中同时统计R和R+,再对齐实际开始执行的 CPU。 - 检查允许的 CPU 集合、同核竞争、调度类、cgroup 配额和 IRQ/SoftIRQ。系统还有空闲 CPU,不代表该线程可以在那里立即运行。
sched.end_state=R+描述上一段 Running 为什么结束;不是 Runnable 切片自身的结束字段。
sched_waking 与 sched_wakeup 的差异与非严格 work-conserving
按 Linux v6.12 的 tracepoint 定义,sched_waking 在发起唤醒的上下文中记录;sched_wakeup 在目标任务实际置为 TASK_RUNNING 时记录,未必仍在同一上下文。后者不只用于跨 CPU 唤醒,也不表示目标线程已经开始执行。sched_wakeup_new 则用于新任务。
Perfetto 调度文档说明,普通调度配置可能为放置和能耗权衡留下排队时间。不能反过来把任何“有空核但仍 Runnable”都归因于节能;先排除 CPU 集合、配额和采集缺失。需要细分唤醒路径时,再结合两类事件及跨核通知,而不是把 sched_waking 当作已经完成入队。
用户态与内核态:sys_* 切片定位空火焰图
sys_* 切片需要 raw_syscalls/sys_enter 与 raw_syscalls/sys_exit;前面的配置没有启用它们。官方 syscall 文档另注明 Android userdebug 构建限制。采集权限和内核支持也要确认。
长系统调用的墙上时间可能包含 Running、Runnable 和 Sleep,不能全部算成内核 CPU 时间。用户态火焰图稀疏时,先查采样是否启用、scope/权限是否覆盖目标、样本数、丢失及 unwinding 错误,再查对应窗口的 syscall 和线程状态。
- 长 syscall 与 Sleep/D 重合:沿具体等待对象查 I/O 或同步依赖。
- syscall 内主要 Running:结合内核采样和调用栈查实际工作。
- 没有 syscall slice:可能没有采集,不能据此认定只剩用户态热点。
CPU 时间与墙上时间
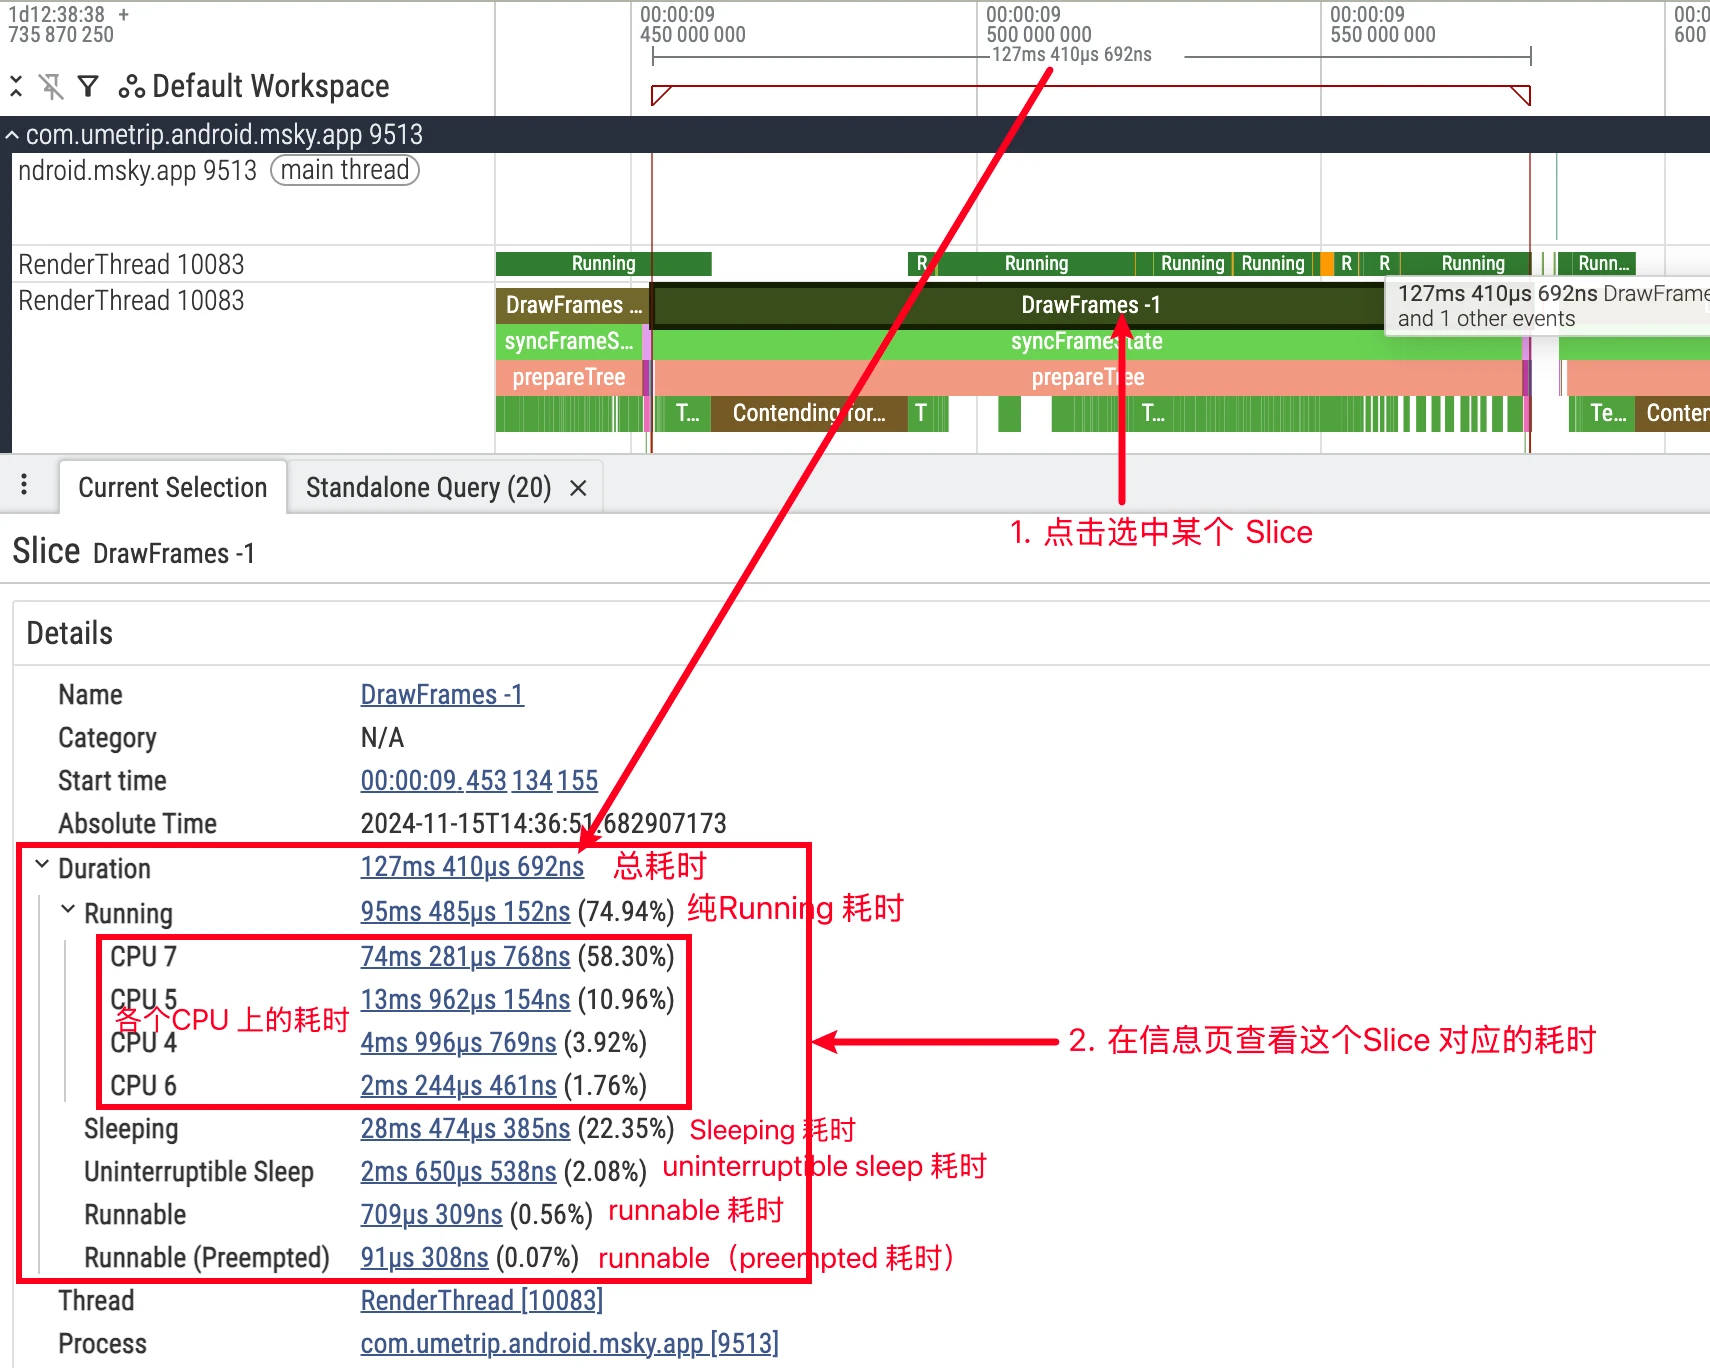
Wall是区间的经过时间;这里的CPU指该线程的 Running 时间,不包含它等待期间其他线程做的工作。- 在线程状态完整、无重叠且按窗口裁剪时,Wall 可分解为 Running、Runnable(含 R+)及各睡眠/阻塞等状态。缺失区间要单列为未知,不能补成零。
- 图中选中的是 RenderThread 的
DrawFrames -1:Wall 约 127.411ms,Running 约 95.485ms,其余包括 S、D、R、R+。这是图中的记录,不能当作每帧预算。 - 对主线程
Choreographer#doFrame也可这样分析。Wall≈CPU 表示主要在核上,不唯一等于算法计算;Wall≫CPU 则继续分辨调度排队与依赖等待。
CPU Frequency (CPU 频率) 深度解析
CPU 频率会影响执行时间与功耗,但频率轨道不是功率计。Linux v6.12 cpufreq 文档说明,scaling_cur_freq 多数情况下反映驱动最近请求的频率,未必是硬件瞬时有效频率;ftrace 的频率事件也受驱动上报能力限制。
影响 CPU 频率的核心因素
- 任务负载:使用
schedutil的系统会参考调度器的利用率信号请求频率;它不是所有 Android 厂商的统一 governor,需读目标 policy 的scaling_governor。请求还受限频、速率限制和硬件响应影响。 - 场景策略(Power HAL):启动、交互等提示由设备实现解释,可能调整频率约束、任务放置或其他参数,不能一律等同抬高
scaling_min_freq/scaling_max_freq。 - 温控:热管理可能限制 CPU/GPU 性能,但实现不一定只改 cpufreq 上限。要有温度、限频或 thermal 状态证据,不能从“频率上不去”单独归因温控。
- 电源与省电策略:电量、供电能力和系统模式也可能限制性能,具体措施依设备而定。
重任务频率偏低时,一并检查运行核、负载、频率 policy、热状态和工作类型;系统约束与应用低效可以同时存在。
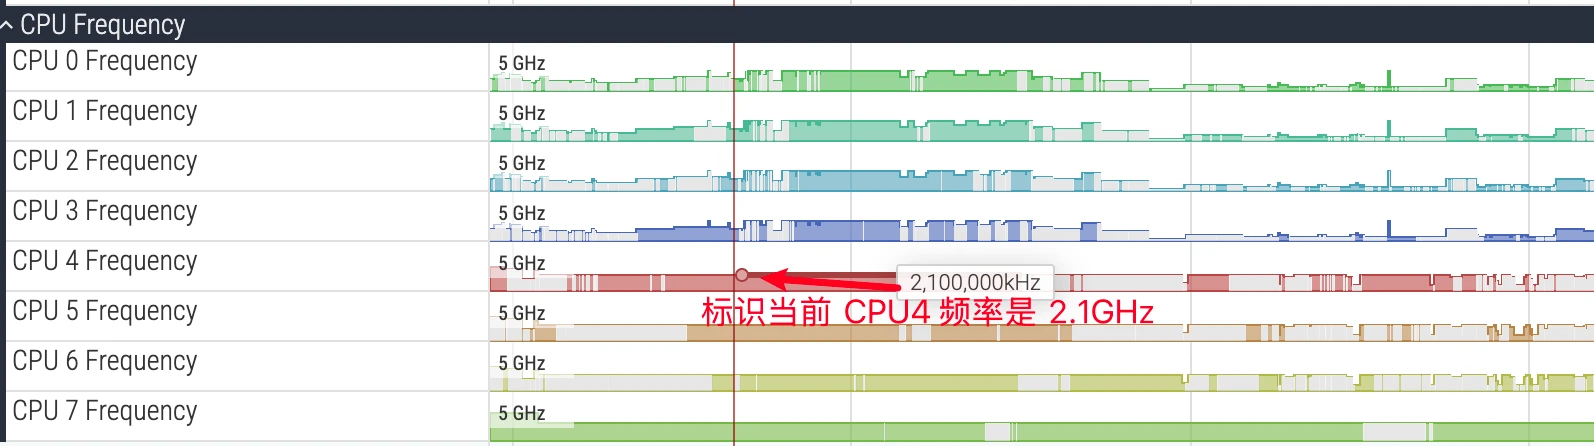
图中鼠标读数 2,100,000 kHz 是 2.1GHz,左侧 5GHz 是纵轴刻度。频率轨道的彩色/灰色叠加表达已采集的非 idle/idle 状态,不是通过颜色直接数 Task。第一张总览另有 Min/Max Freq Limit 轨道,它们与当前频率不是同一数据。
频率数据采集与平台差异
Perfetto 频率与 idle 文档给出两种采集路径:
power/cpu_frequency:记录驱动上报的变化,平台未发事件时没有数据。事件前的未知频率不能自动填成零。linux.sys_stats的cpufreq_period_ms:轮询可读的 sysfs 值,为事件流补充快照,但不能恢复两次采样之间的变化。路径不存在、权限不足或核离线时不能保证完整覆盖。
共享 cpufreq policy 的 CPU 常同时变频,但 policy 与“小/中/大”标签不必一一对应。Perfetto v58.3 的 CPU Frequency 插件通过 LEFT JOIN 关联可选 idle 轨道,缺 idle 不会自动取消频率轨道。
补充 CPU Idle 的读法:power/cpu_idle 原始 counter 中 4294967295(0xffffffff)表示退出 idle;0 可以是第一个 idle 状态,不能把原始数值 0 当成“正在运行”。状态编号与唤醒延迟依 SoC 定义,CPU idle 不等于整机 suspend。空闲时图上的频率可能只是进入 idle 前最后一次上报值,不能用它直接计算耗电。
big.LITTLE:相同频率不等于相同性能或能耗
- 在异构 CPU 上,同为 2.0GHz,小核与大核的实际算力和能耗并不等价。频率必须结合核心类型理解。
- 核心容量(capacity)与 IPC:大核通常能在同频下更快完成计算,但不保证同一任务总能耗更低;还要计入电压、工作时间和空闲状态。
- 簇级 DVFS(cluster-level DVFS):移动 SoC 多以“簇”为单位调频。小核簇的高频并不等同于大核簇的中频性能输出;不同簇的电压-频率-能量曲线不同,同一频点无法横向类比“每瓦性能”。
- 内存/缓存/互联瓶颈:热点若受制于内存带宽、LLC 命中率或系统互联(NoC),单纯提升小核频率收益有限;更大的缓存或更强的预取有时能缓解等待,但效果依访问模式与共享瓶颈而定。
- 能效曲线非线性:小核在接近最高频时常进入能效陡降区(电压抬升使边际能耗激增),而大核在中等频点可能达到“更高单位能效”。同频比较忽略了“电压-频率-能量”的三维权衡。
P-States 与 governor
P-State 是性能状态的概念;具体驱动可能提供离散频率表,也可能接受性能范围并由硬件自主调节,不能把每次图形变化都解释成 schedutil 切换一个离散 P-State。
- 在 CPU Frequency 查看已上报频率;要判断上限/下限,另查 policy 或已采到的 limit 轨道,不能从当前频率曲线推出上限。
- 在 CPU Scheduling 查看关键线程实际运行核,结合已核实的拓扑。
- “高频 + 较小核心 + 仍慢”只是线索:继续看执行内容、缓存/内存访问和调度约束,再决定优化代码还是系统策略。
需要比较能效时,使用相同工作量、热状态和可用的功率/能量测量,不能按 GHz 高低替代测量。
ADPF / Performance Hint 应该怎么看
PerformanceHintManager 从 Android 12 / API 31 提供。Session 面向一组相关线程,报告目标工作时长和实际工作时长,由系统尝试调整放置或性能;设备不支持时创建可能返回 null。它不保证提频,也不是锁定大核的 API。
- 先确定周期工作及其预算。刷新间隔 16.6/11.1/8.3ms 不自动等于 App 可用的全部工作时长,还要考虑流水线与预留时间。
- 用同一窗口的 Running、Runnable、等待和采样判断瓶颈。提示可能影响调度,但不能消除锁依赖或替代代码优化。
- 对比实际工作时长、核放置和频率,并控制场景、热状态和后台负载;一次 API 调用或一次迁核不能证明 hint 的效果。
- 继续检查热/功率限制。提示不构成绕过这些约束的保证。
目标时长应反映这组线程本轮工作的预算;不要把整帧周期或上一轮耗时不加区分地填进去。
CPU Profiling、火焰图与符号化
CPU 状态回答线程是否拿到 CPU;on-CPU sampling 则帮助判断它在运行时执行了什么。先确定问题窗口与目标线程,再看 Running 占比、样本和调用栈。如果目标主要在 R/S/D,也可采样竞争者或依赖线程,但只看目标线程的 on-CPU 火焰图无法解释整个等待链。
Perfetto v58.3 的 CPU profiling 指南使用 linux.perf,需启用 callstack_sampling 才采调用栈,前面的 CPU Config 不包含它。该版本指南的 Android 录制流程要求 Android 15+;user 构建还要求目标 App 可 profile/debug,不能据此断言所有旧版本均支持或均不支持。
| 方式 | 适合场景 | 注意点 |
|---|---|---|
Perfetto linux.perf |
同时间轴关联调度与调用栈 | 检查采样事件、scope、权限、开销和丢失 |
| simpleperf | App/native 热点与符号化 | 保存 perf.data、匹配的二进制及符号 |
| Gecko Profile JSON | 从 simpleperf 导出到 Perfetto UI 或 Firefox Profiler | 转换保留的时间与权重口径需核对 |
Android 16 simpleperf 脚本文档给出 gecko_profile_generator.py -i perf.data 导出路径;不要把它笼统叫作“生成 Perfetto protobuf”。binary_cache_builder.py -lib 可从匹配的符号目录收集二进制,native build ID、ART/JIT 信息和设备系统库版本仍需对应。
采样不是逐函数计时。以按 CPU 时间约 100Hz 的采样作量级估算,单线程持续运行 10s 约对应 1000 个机会,80ms 只有约 8 个;这不是硬性上限或保证,实际数量受采样事件、频率调节、迁核和丢失影响。按硬件事件周期采样更不能直接按墙上秒数乘频率。
- self:栈叶节点自身的样本数或权重,不含子调用。
- cumulative:该节点及其子树的样本数或权重。不同节点可能包含同一批样本,不能逐行相加当总量。
只有合适的时间采样与权重才能近似解释成 CPU 时间占比。符号化也是容易踩坑的一步:unknown 一多,先别急着优化代码,看看是缺符号、栈展开失败,还是采集范围不足。未知部分不能直接算给某个函数。
下面是报告格式示意,不是本文截图的实测结果:
1 | 窗口:12.300s - 12.860s |
回到时间轴核对热点是否落在用户感知窗口。不要把整段录制的火焰图直接当成某个晚帧的原因。
Linux 内核调度策略:选核与迁移
EAS(Energy Aware Scheduling)参与满足条件的 fair-class 任务放置,不是 Android 的全部调度器,也不替代实时调度类或每个 CPU 上的任务选择。下面按 Linux v6.12 EAS 文档说明一般思路;厂商内核、利用率跟踪与策略可能不同。
选核逻辑 (Task Placement)
启用 EAS 且适用时,唤醒选核会结合任务历史利用率、允许的 CPU 集合、CPU 容量与当前负载,并利用 Energy Model 估算不同放置的能量成本。
- 评估负载:利用率来自运行历史及估计,不是调度器预先知道下一轮要做多少工作。
- 筛选候选:考虑容量与剩余空间,并受 affinity/cpuset 等限制。不是遍历所有物理核后简单判断
capacity > util。 - 比较能量估计:模型比较候选放置对 performance domain 的影响;它是估计,不是实时测得的整机功率,也不保证全局最优。
EAS 通常更适合轻中负载。在 root domain 进入 overutilized 状态时,相关路径会转向负载均衡,不能把高负载下的所有迁移都解释成 EAS 选了“最省电”的核。
核心迁移逻辑 (Task Migration)
线程可以在唤醒时选择另一 CPU,也可以由负载均衡等路径迁移;实际路径受 CPU 集合、调度类和厂商策略约束。
- 负载均衡:在适用的调度域内平衡负载或处理容量不匹配。另有空闲大核不代表一定允许把目标线程拉过去。
- 唤醒放置:根据保留/衰减的负载估计、其他线程负载等选择 CPU。收到一个大下载任务不会让尚未执行的线程历史
util立即飙升;工作量突变可能需要后续运行或提示才能反映出来。
线程在大小核之间“反复横跳”,或长时间在较小核心上运行,都值得调查,但不单独证明调度错误。核对关键路径、允许核集合、利用率与性能结果,再判断是否影响截止时间。厂商定制要以对应设备 trace 和实现证据解释,不能从引擎商品名推导选核算法。
实战与 SQL
使用 SQL 进行量化分析
以下查询按 Perfetto v58.3 的调度表及进程/线程视图中的 sched、thread_state、thread 与 process 字段编写,范围限定为单设备 trace。utid/upid 是 trace 内实例身份,不能用 name 或可能复用的 tid/pid 替代。
查询保守排除 dur <= 0:特别是 dur = -1 的未闭合区间不能直接求和。因此结果是已知完整区间的观测时长,丢事件或尾部未闭合可能使它低估;不是自动补齐的总时长。使用前应在目标 Trace Processor 版本检查 schema 和 trace 完整性。
先列出线程及所属进程,按进程、tid、名称和生命周期选中一个 utid,不要用 name = ... LIMIT 1 猜:
1 | SELECT |
若改成窗口 [start, end),应累加 max(0, min(ts + dur, end) - max(ts, start)) 的交集时长;只按起始 ts 筛选会漏掉跨边界部分。多设备 trace 还要用 machine/ucpu 区分 CPU。
1. 计算各进程的 CPU 总时长
按 upid 区分进程实例,保留 pid/name 便于阅读;同名进程不会被合并。这里只统计能关联到 process 的已知非 idle 线程。
1 | SELECT |
2. 分析单个线程的时间状态分布
先在上面的身份查询中确认目标 utid,再替换 NULL;不替换会返回空结果,不是“该线程耗时为零”。直接保留状态编码,R+ 与 R 分别统计,其他状态也不会丢失。
1 | SELECT |
3. 查找整份 Trace 中 CPU 消耗最高的线程
按 utid 区分线程实例,避免 tid 复用或同名线程合并。这是整份 trace 的已知运行时间排名;窗口分析需要裁剪跨边界切片。
1 | SELECT |
4. 查看线程在各 CPU 核心上的运行时间分布
替换为选定的 utid。运行分布说明实际在哪些 CPU 执行,不等于线程配置的 CPU affinity 掩码;从未运行过的允许核不会出现在结果中。
1 | SELECT |
5. 计算各进程的 CPU 利用率
下面保留“按核数归一化”的口径,但分母是 trace 时长 × 有调度记录的不同 CPU 数,结果名明确为 observed capacity。它不是硬件全部核心、在线核时间积分或异构容量加权利用率。核离线、CPU 未采全或 trace 跨整机 suspend 时,这些口径会不同。
1 | WITH observed_cpus AS ( |
去掉分母中的 c.n 即为单核基准,进程并行时可以超过 100%。频率与核容量没有纳入这个百分比,不能拿它直接比较两款 SoC 的工作量或耗电。
总结
排查 CPU 问题时,先在目标窗口里分开计算 Running、Runnable 和 Sleep;Runnable 长先查调度与竞争,Running 长再看采样热点,Sleep/D 长则查等待对象。频率和核簇提供背景,但单个频点不能替代线程状态与业务窗口的证据。
关于我 && 博客
下面是个人的介绍和相关的链接,期望与同行的各位多多交流,三人行,则必有我师!
- 博主个人介绍 :里面有个人的微信和微信群链接。
- 本博客内容导航 :个人博客内容的一个导航。
- 个人整理和搜集的优秀博客文章 - Android 性能优化必知必会 :欢迎大家自荐和推荐 (微信私聊即可)
- Android性能优化知识星球 :历史社群介绍,2026 年已关闭。
一个人可以走的更快 , 一群人可以走的更远