SmartPerfetto 的版本更新以后集中写在这一篇,新的记录放在最前面。这里合并了此前几篇更新文章,主要保留版本范围、时间和重要变化。
目前整理到 v1.15.1(2026-10-06)。这是本文覆盖的版本,不代表项目的最新发行版;下载请看 GitHub Releases。

SmartPerfetto 的版本更新以后集中写在这一篇,新的记录放在最前面。这里合并了此前几篇更新文章,主要保留版本范围、时间和重要变化。
目前整理到 v1.15.1(2026-10-06)。这是本文覆盖的版本,不代表项目的最新发行版;下载请看 GitHub Releases。
Android 内部机制的资料,网上不缺。AOSP、官方文档、博客、论文、trace 讨论,想找都找得到。麻烦的是各说各的版本:这篇是 Android 12 的结论,那篇没写版本,再一篇是某台机器上的现象。
AIW 想补的就是这个缺口。全称 Android Internal Wiki,中文书名是《Android 技术内幕:系统机制、性能优化与工具实战》,五部分二十六章,正文钉在 Android 17。仓库现已公开:
https://github.com/Gracker/android-internals-wiki
打开仓库能拿到的是二十六章正文、一份完整目录,和每周编一次的 EPUB。
这二十六章现在到了可以拿出来给人读的程度。读到哪一段和源码对不上,欢迎提 issue 或者 PR。
按钮按下后,按压态何时出现?滑动列表时,内容何时第一次跟着手指移动?这两个问题都要找到输入事件和对应的第一帧反馈;启动总耗时与后续动画帧率回答的是别的问题。
本文用 Perfetto 把 InputReader 读到事件、InputDispatcher 派发、App 处理、帧提交和 SurfaceFlinger 呈现分开计时。每一步的起止点要能回到 Trace 核对。
从 InputReader 的 read_time 到关联帧 present,可以得到系统内部延迟的候选值 estimated_input_to_present_ms。只有确认目标 layer、业务状态确实在那一帧发生视觉变化,才把它写成 input_to_present_ms。这段时间不包含触控 IC、驱动上报前延迟、显示扫描和面板响应。
点击和滑动还需要不同的终点定义:按压态、转场首帧和内容第一次位移不能混成一个数。App marker 能说明业务动作,高速相机可补外部可见时点。
Camera 打开慢要区分 API 返回、HAL 首个 Buffer 和预览画面显示;Audio underrun 要看 App 写入与 mixer 周期是否稳定。这些事件分散在 App、系统服务、HAL 和调度轨道里,单列一张 Top slice 表还原不了顺序。
这里用 Camera 和 Audio 两个场景说明:先确认一次操作涉及哪些进程和线程,再按阶段或真实周期计算耗时,最后把异常时间点、来源轨道和质量限制写进报告。平台侧还要维护稳定的事件名和采集配置,下一次 Trace 才能复用查询。
FrameTimeline 标出一帧晚了,主线程和 RenderThread 没有明显长任务,下一步可以查 GPU 工作与 fence。GPU 频率、电池电流和电源轨只能提供同一窗口的硬件状态,不能单独证明某个 App 帧为何晚呈现。
这篇把 GPU render stages、devfreq、电池计数器和电源轨放到同一段 Trace 窗口里,说明各自能回答什么、设备不支持时报告该怎么写。帧和线程的判读可接着第 7 篇与第 8 篇的例子读。
Counter 名称、单位和采样周期由设备 producer 决定。跨设备比较前先核对 descriptor;同一设备上也要确认目标帧与 GPU 工作是否能通过 token、layer 或 fence 关联。
开机慢、亮屏后偶发卡顿或几小时后才出现的音频断续,通常等不到工程师连上电脑再按「开始录制」。要保留问题发生前的调度、帧或音频事件,采集配置必须提前在设备上运行。
现场抓取要先确定触发点前后各保留多久,再选 Ring Buffer、周期写文件或 trigger。文件写出后,还要确认问题窗口没有被覆盖、关键数据源没有丢失。设备开机属于更早的特殊窗口,单独处理。
dumpsys meminfo 显示进程内存上涨,Java heap dump 却没有对应的对象增长时,下一步先查上涨落在 Native Heap、图形 Buffer,还是其他映射。若可疑部分来自 malloc/new,heapprofd 可以把分配与调用栈对应起来。
heapprofd 的分配、释放和调用栈记录能与业务事件放在同一条 Perfetto 时间轴上,便于核对一次操作前后哪些分配仍未释放。
heapprofd 是采样工具,看到的 native allocation 不能直接当作 RSS,也不覆盖 Java 对象引用或所有图形 backing 内存。先分清内存账,再决定是否抓 profile。我更倾向先用 meminfo 和 smaps 把上涨来源拆开,再打开 flamegraph;若涨的是 GraphicBuffer,盯着 malloc 调用栈改代码就找错了方向。
系统 Trace 能显示线程、CPU、帧和 Binder 等系统事件;播放器的 frame id、游戏 scene 名称或业务队列里的等待时间,需要应用自己提供。缺少这些标记时,一段主线程耗时只能定位到系统活动,难以对应业务阶段。
Perfetto SDK 的 Track Event 可以记录解码、纹理上传、队列深度和跨线程任务 ID。与系统轨道放在同一个时间窗口后,能先找到业务候选阶段,再用 RenderThread、GPU 和 FrameTimeline 验证它是否影响了可见帧。
接入前要先定事件名称、参数单位和采样频率。否则埋点虽然能显示在 UI 中,后续 SQL 仍无法稳定地按业务阶段聚合。
一份 Trace 能在 UI 里打开、SQL 也查得到行,仍可能在采集中丢过数据。线程状态缺一段、进程名对不上、Track Event 只有 ID 没有名称时,先查数据丢在哪一层,再决定哪些分析还能继续。
SQL 只能度量留下来的事件。丢失发生在 ftrace、producer 共享内存还是 central buffer,影响的查询不同。看到一条 ftrace loss,我不会立刻扔掉整份 Trace;先查它影响的是调度、业务标记,还是帧数据。
下文沿事件从内核进入 Trace 文件的路径检查 ftrace、producer 共享内存、central buffer、增量状态和 flush。每一处都有对应的 stats 线索和下一次采集时可调整的配置。
在 Perfetto UI 里框出问题窗口,看主线程、RenderThread 和 CPU 状态,再截几张图,单次定位很方便。换一份 Trace 或换一台设备,截图里的判断就难以按同一口径重算。我更关心的是:下次拿到同一类问题,还能不能算出可复查的数字。
PerfettoSQL 与 Trace Processor 可以把时间窗口、线程身份和耗时口径写进查询,再让 Python 对多份 Trace 执行同一段 SQL。这样复测版本时,能回到每份原始 Trace 核对数字。
下面从一条手工判断出发,逐步得到可批量执行的查询和结构化输出。示例代码需要替换目标进程、时间窗口和采集条件后再用于自己的场景。
SmartPerfetto 已经完整开源。打开仓库能看到当前可运行的主干工程:Perfetto UI fork、后端 agentv3、MCP 工具、YAML Skill、场景策略、脚本和文档。没有保留私有核心模块,也没有只放一层 demo 壳。
这个项目来自一个很具体的日常场景:手里有一条 trace,Perfetto 已经把事实摆出来,但从事实到判断还要翻表、写 SQL、对线程、看 FrameTimeline、找 Binder 对端,再回到时间线上确认一遍。SmartPerfetto 想把这些重复动作固化成工具,让性能工程师把时间花在判断上。
它还处在开发阶段。现在放出来,是因为 trace 分析靠真实样本长出来:真实设备、真实厂商差异、真实业务 trace、真实 PR,都会改变 Skill 和策略该怎么写。等所有能力都稳定后再单向发布,反而会错过最需要样本的阶段。
如果你日常会打开 Perfetto 看滑动卡顿、启动、ANR、Binder、CPU 调度或渲染管线,SmartPerfetto 提供的是一个带 AI Assistant 的 Perfetto UI:加载 trace 后,用自然语言提问,后端查询 trace_processor_shell、调用 YAML Skill、组织证据,再把结论和数据表格流式显示在浏览器里。
项目地址:
普通试用只需要看主仓库。Gracker/perfetto 是 perfetto/ submodule 对应的前端 fork,主要给需要改 AI Assistant 插件 UI 的开发者使用。
前两篇技术文档更适合想看工程细节的读者:
前两篇把内部架构讲得比较细,但源码放出来以后,读者更关心的是仓库里到底有什么、能不能跑、哪些地方还没稳。这篇主要补开源这件事:开放了什么、当前能做什么、内部怎么分工、怎样在本地跑起来、哪些地方适合一起改。
这篇文章收集了《从 Trace 到洞察:SmartPerfetto AI Agent 的 Harness Engineering 实战》发布后收到的技术问题。它不重复正文的大段叙述,而是把最容易追问的设计点单独拆开。如果你已经读过正文,这里更适合作为二次阅读和交叉检索。
这篇文章记录了 SmartPerfetto 从零到可用过程中的关键技术决策。重点放在每次架构取舍背后的约束、失败案例和修正过程,而不是功能清单。如果你也在做 AI Agent 应用,或者在做 Perfetto 这类性能分析工具,这些工程折返点应该能直接参考。
文章按三层展开:先说清楚为什么 LLM 不能直接吃 Trace,包括上下文装不下、数值计算不可靠、领域知识用不上来三个原因;然后是从 Workflow 到 Agent 的迁移过程,附带 9 轮审查里挖出的冷启动 4 层联动 Bug 和 Ghost MCP Query 这类异步生命周期错配的具体案例;最后是 Scene Classification 按需加载、Artifact Store 控制返回数据量、三层验证从误判中迭代这三个关键决策为什么这么定。
在 Perfetto 里看到 vsync-app、vsync-sf 和 App 的 doFrame,很容易把三条轨道当成同一个时刻。这篇沿一次帧请求看 VSync 怎样从 SurfaceFlinger 的调度进入 App,接着怎样和 RenderThread、Buffer、FrameTimeline 对齐。
示例以 120 Hz 设备为主。相位配置、是否启用硬件 VSync,以及 App 是否请求下一帧都会改变轨道形态;本文先分清每个信号代表什么,再谈延迟。
版本说明(2026-10 核查):Java、JNI 和调度代码按
android-16.0.0_r1核对;app/appSf 的分工另引用 Android 13 源码。截图保留历史设备样例,不把它们视为 Android 16/17 的统一配置。代码省略外围状态时会明确说明,片段来自不同类,不能直接拼成可编译程序。
一次滑动卡顿,主线程可能在处理布局,也可能早已把绘制命令交给 RenderThread。这篇用 Perfetto 截图对照两条线程、Buffer 提交和 SurfaceFlinger,找出等待发生在哪一步。
先沿截图读一帧,再看 ActivityThread、RenderThread 和 BLASTBufferQueue 的职责。Trace 能缩小调查范围;帧最终是否上屏,还要核对 FrameTimeline 与合成侧记录。
120 Hz 把显示刷新间隔从 60 Hz 的约 16.67 ms 缩短到约 8.33 ms,但屏幕刷新率、App 产帧率和用户看到的帧并不是同一个数字。这篇从一份 Perfetto Trace 出发,解释三个数字怎样对应,以及高刷新率给渲染和功耗带来的取舍。
第 5 篇已经介绍 Choreographer 的回调顺序,这里重点看更短的显示周期。文中的设备截图只说明那次采集,不能代表所有 120 Hz 机型的调度配置。
本篇是 Perfetto 系列文章的第四篇,如何使用 trace_processor_shell 在本地打开超过 2G 的大文件。在实际的问题分析过程中,我们经常会碰到非常大的 Trace 文件(大于 2GB),直接扔进 ui.perfetto.dev 可能会因浏览器内存限制而打不开;这里的限制是解析时的内存占用,并不是文件超过 2GB 就一定打不开。这时候我们就可以使用官方提供的 trace_processor_shell 工具来本地打开大文件。
写下这个系列时,Perfetto 在我的日常工作中已经基本取代 Systrace,我接触到的 OPPO、vivo 团队也在迁移。许多刚做 Android 性能优化的小伙伴觉得 Perfetto 界面眼花缭乱、功能复杂,希望我能把之前的 Systrace 文章用 Perfetto 再讲一遍。
本篇是 Perfetto 系列文章的第三篇,前两篇介绍了 Perfetto 是什么以及 Perfetto Trace 怎么抓,本篇主要是在网页端打开 Perfetto Trace 之后,面对复杂的 Perfetto 信息该怎么看。
Android 官方将 Systrace 列为 legacy 工具,并推荐在 Android 10 及以上使用 Perfetto。写下本文时,Perfetto 在我的日常工作中已基本取代 Systrace,我接触到的 OPPO、vivo 团队也在迁移,因此用这个系列继续介绍如何观察 Android 系统。
技术核查:2026-10-14。 保留 2024 年界面与案例截图,快捷键和分析语义按官方文档及 v58.3(
11fbaed83636)源码补充。原始案例 Trace 未随文提供,图中的唤醒链和数值不当作新版本实测结果。
上一篇文章 Android Perfetto 系列 1:Perfetto 工具简介 介绍了 Perfetto 是什么,这篇简单介绍一下 Perfetto 的抓取。
Android 官方将 Systrace 列为 legacy 工具,并推荐在 Android 10 及以上使用 Perfetto。写下本文时,Perfetto 在我的日常工作中已基本取代 Systrace,我接触到的 OPPO、vivo 团队也在迁移,因此希望把原来的 Systrace 分析方法用 Perfetto 再讲一遍。
技术核查:2026-10-14。 本文以 Android 12+ 设备为主要示例,保留 2024 年截图;旧系统与新版 UI 的差异在对应段落说明。命令和配置按官方文档、脚本核对,本文未新增真机采集结果。
本篇是 Perfetto 系列文章的第一篇,主要是简单介绍 Perfetto 工具,包括 Perfetto 的历史、发展,以及 Perfetto 能做什么。
Android 官方将 Systrace 列为 legacy 工具,并推荐在 Android 10 及以上使用 Perfetto。写下本文时,Perfetto 在我的日常工作中已经基本取代 Systrace,我接触到的 OPPO、vivo 团队也在迁移。许多新接触 Android 性能优化的小伙伴面对复杂的界面和功能,希望我能把之前的 Systrace 文章用 Perfetto 来呈现。
技术核查:2026-10-14。 本文初稿和截图来自 2024 年,保留当时的使用体验。下面补充 Android 10/11/12 的数据源边界,以及 Perfetto v48.0/v49.0 的 UI 更新;具体可见数据仍取决于设备、采集配置和工具版本。
Perfetto 在我的日常工作中已基本替代旧的 Systrace 工作流。Android 官方建议在 Android 10 及以后使用 Perfetto,并将 Systrace 命令行工具列为 legacy。许多新接触 Android 性能优化的小伙伴觉得 Perfetto 的界面和功能复杂,希望我能把之前的 Systrace 文章用 Perfetto 重新呈现,于是有了这个系列。
This is the historical English version of Yingyun’s article. See the Chinese original or the English-site version.
I am starting a series about the decisions involved in OS architecture. The same questions arise when designing other large software systems too.
My knowledge and experience have limits, and these views are subjective. There will be gaps. I would like to hear other views and see what I have missed.
本文是之前星球里 Yingyun 大佬的文章,由于星球已经关闭,所以把这个关于 OS 性能设计的系列文章发到博客上
Yingyun 是资深性能优化专家,他对于系统优化有非常深入的见解,本身在国内各个手机大厂都呆过,他本人的博客还在休整中,等休整好了我再发出来,目前他在我们的微信群里很活跃,对本文有什么建议或者意见,或者说想咨询问题的可以加我们的微信群(加我微信 553000664,备注博客加群,我会拉你进去)
新开系列文章,OS 架构设计中的各种考量因素。其实不止 OS,在设计任何大型软件都涉及到此类内容。
能力与知识面有限,而且还带了非常主观的看法,肯定有不足之处。希望听到不同的思路与观点,通过观点的碰撞进而达到更进一步的认知。
2023 年,公开研究披露了某款 Android App 中的漏洞利用代码和动态下发的 DEX。我想看看这些代码尝试调用哪些系统能力,于是有了这篇文章。当时准备仓促,有些代码没有仔细看;下面保留分析过程,并修正能从截图和 AOSP 源码确认的问题。原始文章和代码链接如下:
我不是安全方面的专家。关于漏洞背景,可以参考 Android 反序列化漏洞攻防史话。本文不复现漏洞链,也不把某个接口调用直接等同于已获得 root。
2022.3.25 ,周五晚上九点,The Performance 知识星球(付费版本)举办了第一次线上茶话会,3 位星球主理人 + 5 位星球嘉宾,50 多位球友参加,非常感谢各位!
第一次茶话会没有预设主题,预计 1 个小时就可以结束,结果聊了 2 个半小时,光是主理人和嘉宾的个人介绍就花了一个小时。平时大家在群里和星球里交流很多,但是通过语音在线交流还是第一次,再者大家的公司基本上涵盖了 Android 上下游:既有 App 大厂的大佬,也有一线手机厂商的系统大咖,也有芯片公司和造车新势力的资深专家。所以在每个人自我介绍的时候,会聊一些公司相关的东西,再发散一下,其他人再问一些问题,时间就过去了。
当时我们还计划不定期举办星球茶话会,把主题定得更明确,也邀请更多嘉宾一起聊,不局限于技术。考虑到隐私问题,这次没有录屏;下面的文字稿根据聊天内容部分还原,不涉及各位的隐私。
本文是 Systrace 线程 CPU 运行状态分析技巧系列的第三篇,本文主要讲了使用 Systrace 分析线程状态时遇到的 Sleep 与 Uninterruptible Sleep 状态的原因排查方法与优化方法,它们常见于正常等待,也可能拖慢关键路径,需要结合等待条件和依赖关系判断。
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。Systrace 基础和实战系列大家可以在 Systrace 基础知识 - Systrace 预备知识 或者 博客文章目录 这里看到完整的目录
本文是 Systrace 线程 CPU 运行状态分析技巧系列的第二篇,主要分析了 Systrace 中线程的 Running 状态出现的原因和 Running 过长时的一些优化思路。
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。Systrace 基础和实战系列大家可以在 Systrace 基础知识 - Systrace 预备知识 或者 博客文章目录 这里看到完整的目录
本文是 Systrace 线程 CPU 运行状态分析技巧系列的第一篇,主要分析了 Systrace 中线程的 Runnable 状态出现的原因和 Runnable 过长时的一些优化思路。
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。Systrace 基础和实战系列大家可以在 Systrace 基础知识 - Systrace 预备知识 或者 博客文章目录 这里看到完整的目录
本文是 Systrace 系列文章的第五篇,主要是对 SurfaceFlinger 的工作流程进行简单介绍,介绍了 SurfaceFlinger 中几个比较重要的线程,包括 Vsync 信号的解读、应用的 Buffer 展示、卡顿判定等,由于 Vsync 这一块在 Systrace 基础知识 - Vsync 解读 和 Android 基于 Choreographer 的渲染机制详解 这两篇文章里面已经介绍过,这里就不再做详细的讲解了。
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
本文是 Systrace 系列文章的第十二篇,主要是对 Systrace 中的 CPU 信息区域(Kernel)进行简单介绍,简单介绍了如何在 Systrace 中查看 Kernel 模块输出的 CPU 相关的信息,了解 CPU 频率、调度、锁频、锁核相关的信息
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
本文是 Systrace 系列文章的第十一篇,主要是对 Systrace 中的 Triple Buffer 进行简单介绍,简单介绍了如何在 Systrace 中判断卡顿情况的发生,进行初步的定位和分析,以及介绍 Triple Buffer 的引入对性能的影响
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
本文是 Systrace 系列文章的第十篇,主要是对 Systrace 中的 Binder 和锁信息进行简单介绍,简单介绍了 Binder 的情况,介绍了 Systrace 中 Binder 通信的表现形式,以及 Binder 信息查看,SystemServer 锁竞争分析等
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
本文是 Systrace 系列文章的第七篇,主要是是介绍 Android 中的 Vsync 机制。文章会从 Systrace 的角度来看 Android 系统如何基于 Vsync 每一帧的展示。Vsync 是 Systrace 中一个非常关键的机制,虽然我们在操作手机的时候看不见,摸不着,但是在 Systrace 中我们可以看到,Android 系统在 Vsync 信号的指引下,有条不紊地进行者每一帧的渲染、合成操作,使我们可以享受稳定帧率的画面。
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些
本文参考了目前大部分 Android 应用启动优化的方案,将大家的方案做一个汇总,如果你有这方面的需求,只需要对照这篇文章,看看其他人的方案,查漏补缺。很多方案是要根据具体的业务去做优化的,所以这里也没有对每一种方案进行详细的介绍,要用到哪一个方案的时候,可以具体去网上查找对应方案的具体实现方法,这里只是做一个汇总
另外我还加上了部分系统厂商所做的启动相关的优化,不过只写了一些我知道的,还有一些厂商有黑科技,就不在这里的讨论范围了。知道厂商做的事情,可能也会帮助到你,比如联系厂商做白名单、接入厂商 SDK 等
本文是 Systrace 系列文章的第九篇,主要是是介绍 Android App 中的 MainThread 和 RenderThread,也就是大家熟悉的主线程和渲染线程。文章会从 Systrace 的角度来看 MainThread 和 RenderThread 的工作流程,以及涉及到的相关知识:卡顿、软件渲染、掉帧计算等
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些
本文是 Systrace 系列文章的第六篇,主要是对 Systrace 中的 Input 进行简单介绍,介绍其 Input 的流程; Systrace 中 Input 信息的体现 ,以及如何结合 Input 信息,分析与 Input 相关的问题
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
技术复核 · 2026-10-13。 保留 2019 年原图、线程列表与作者观点。技术核对基线为 AOSP
android-9.0.0_r1、android-16.0.0_r1;补充 API 31 帧时序与 DataStore 1.2.1 等现代入口。截图不是当前应用版本的测试结果,本次未做原设备或完整 Trace 复现。
在Android 中的卡顿丢帧原因概述 - 系统篇 这篇文章中我们列举了系统自身原因导致的手机卡顿问题, 这一篇文章我们主要列举一些由于 App 自身原因导致的卡顿问题. 各位用户在使用 App 的时候, 如果遇见卡顿现象, 先别第一时间骂手机厂商优化烂, 先想想是不是这个 App 自己的问题.
手机厂商和 App 团队会使用 Matrix 或自有方案收集线索,系统权限可增加可见信息,但数据范围仍取决于构建、采集配置和平台支持。
平均 FPS 不能单独代表流畅度。相同的 55 FPS 可以有不同的帧间隔和停顿分布;分析时需要目标节奏、实际呈现和输入响应,不能把 60→55 直接当作具体掉帧原因。本系列四篇如下:
技术复核 · 2026-10-13。 本文案例与截图来自 2019 年。此次按 Android 8.1/9/16 的相关源码、Linux v6.6 文档及现行 Android 文档核查,保留原始图片和作者经验;修正将长 slice、核号、内存回收或输入节奏直接等同根因的结论。没有重新运行原设备或回放完整 Trace,缺少的现场条件不作补造。
在应用篇中,我们列举了应用侧的卡顿问题。这一篇沿系统服务、显示、调度和内存路径整理案例。各设备的硬件、内核与厂商实现不同,定位时应保留系统版本和具体配置。
手机厂商和 App 开发者通常会通过优化组、Matrix 或自有监控方案收集线索。系统权限有助于获取更多数据,但采集范围仍受构建类型、内核配置和数据源开关影响。
流畅度不能仅等同于平均 FPS。60 Hz 下的一秒平均 55 FPS,无法说明延迟集中在哪几帧,也不能直接代表所有人的感知;应检查目标节奏、实际呈现间隔和输入响应。静止界面不需要每个刷新周期提交新内容。本系列四篇如下:
技术复核 · 2026-10-13。 本文保留 2019 年厂商优化组的工作经验与当时的行业观点。技术部分补充 Android 12(API 31)FrameTimeline、JankStats 与 Macrobenchmark 的适用边界;Looper 日志语义按 AOSP
android-9.0.0_r1/android-16.0.0_r1核对,Matrix 功能以 v2.1.0 文档为版本示例。本文未进行新的设备测量。
Android 手机使用中的卡顿问题,手机厂商和 App 开发商都会重视,内部一般会有基础组或者优化组负责分析和优化。
第三方工具如腾讯 Matrix 可以提供应用侧性能线索。厂商也会有自己的监控方案,借助系统源码和相应调试权限获取更深层数据;实际可见范围仍取决于系统版本、内核配置、构建类型和采集开关。
流畅度不能只用一秒内的平均 FPS 表示。相同的平均 55 FPS,可能包含一次明显停顿,也可能是较均匀的帧间隔,体验并不相同。要结合目标更新节奏、实际呈现间隔和输入响应看问题。60/90/120 Hz 的刷新间隔分别约为 16.67/11.11/8.33 ms,但它们不是所有线程合计的固定 CPU 时间预算;静止界面也不需要每个刷新周期都提交新内容。
引起卡顿的原因可能来自 App、系统、内核或显示链路。本系列分为四篇:
技术复核 · 2026-10-13。 本文保留 2019 年四种启动模式的操作记录,按 AOSP
android-9.0.0_r1、android-16.0.0_r1核对任务选择、affinity 与最近任务行为,并补充 Android 12(API 31)的 singleInstancePerTask。旧记录未注明设备完整版本,本次没有真机重跑,不能当作当前系统的逐步实测。
Android 中的 Activity 有几种重要的启动模式:standard、singleTop、singleTask、singleInstance。网上讲这些模式的文章不少,我这里写了个 Demo,想从任务中的 Activity 排列给大家看它们的区别;较新的 singleInstancePerTask 放在后面补充。
普通任务内导航通常后进先出。下方 A -> B 表示操作顺序;“栈内容”按顶部在前列出实际排列。留意每一步之后的变化,边操作边对照会好理解一些。重复发起启动不一定增加实例。Task 是系统管理的任务,不等于进程,也不等于最近任务列表中的一张卡片。
Demo 我也放到了 GitHub:AndroidLunchModeTest。本次核对的快照为 eaa1f987e332e0f85187a911ad9ae01cd20fff05。工程 compile/target SDK 29、min SDK 26;源码包名为 com.example.lunchmodetest,与下方保留的旧日志 com.example.launchmodetest 不同。
运行前需要按每个案例核对所有跳转目标:快照中 MainActivity.startSingleTopActivity 实际跳到 SingleTaskActivity,StandardActivity 默认跳到 SingleInstanceWithAffinityActivity,仅改一个目标无法自动跑完全部案例。类名 WithAffinity 表示旧命名,实际 manifest 配置为空 affinity;SingleTopWithAffinityActivity 甚至未声明 singleTop,不能凭类名判断模式。本次只核查代码,没有改动或编译这个示例工程。
下面先按同一用户、普通前台 Activity 发起、无额外 Intent flags 的条件解释。若把旧工程升级到 target SDK 31+,还需为带 intent-filter 的组件显式配置 android:exported,其中 Launcher 入口设为 true。
2026-10-13 技术更新:本文保留 2019 年起积累的旧 Systrace 截图,其中也有后补的案例。颜色与快捷键属于 legacy UI;Linux 状态说明参照 v6.6 文档,现代入口核对到 Perfetto UI v58.3(11fbaed83)。原图里的 Self Time、唤醒及调度状态注释有几处不准确,已在相邻正文说明;截图不等于本次设备实测。
本文是 Systrace 系列文章的第二篇,主要是讲解一些分析 Systrace 的预备知识, 有了这些预备知识, 分析 Systrace 才会事半功倍, 更快也更有效率地找到问题点.
本文介绍了如何查看 Systrace 中的线程状态, 如何对线程的唤醒信息进行分析, 如何解读信息区的数据, 以及介绍了常用的快捷键. 通过本篇文章的学习, 相信你可以掌握进程和线程相关的一些信息, 也知道如何查看复杂的 Systrace 中包含的关键信息
2026-10-13 技术更新:保留原有历史截图和代码。文中代码片段已对照 AOSP
android-10.0.0_r1,现代差异以android-16.0.0_r1为例;这不表示原截图运行的就是这些版本,原始 Trace、ROM 和构建信息并未附上。窗口动画归属、StartingWindow 与线程相互影响的旧说法已在下文修正。
本文是 Systrace 系列文章的第四篇,主要是对 SystemServer 进行简单介绍,介绍了 SystemServer 中几个比较重要的线程,由于 Input 和 Binder 比较重要,所以单独拿出来讲,在这里就没有再涉及到。
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
2026-10-13 技术更新:原文发表于 2019 年,旧 Systrace HTML 和脚本步骤保留作历史参考。现代抓取示例以 Android 11 / API 30+ 为起点;应用 Trace API、权限和数据源的版本边界另行注明。本文同时区分设备端
atrace、主机端systrace.py与perfetto,参数不能混用。
本文是 Systrace 系列文章的第一篇,主要是对 Systrace 进行简单介绍,介绍其简单使用方法;如何去看 Systrace;如何结合其他工具对 Systrace 中的现象进行分析。
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
2026-10-13 技术更新:本文原发表于 2019 年,以 60 Hz 设备解释帧节奏。60 FPS 不是所有 Android 设备的固定标准;旧文中的统一 16.67 ms 预算、帧率不匹配及功耗结论已在下文修正,并补充 Android 11 / API 30、Android 12 / API 31 起的适配与分析入口。
本文是 Systrace 系列文章的第三篇,解释一下为何大家总是强调 60 fps。这里的 FPS 指应用画面的帧率,Hz 指屏幕刷新率,两者统计的对象不同,可以参考这篇文章:新的流畅体验,90Hz 漫谈
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 的运行,从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
本文先分清帧率与刷新率,再讨论帧节奏、功耗和响应延迟。到了 90 Hz、120 Hz 设备上,仍需要让内容更新与显示时序配合,但不再把 60 FPS 或 16.67 ms 当成统一标准。
2026-10-13 技术更新:本页原标注日期为 2019 年,保留了更早教程的更新记录。旧 Systrace 工具流程已过时;历史截图、源码和实验按各篇注明的 Android 版本阅读,不能直接当作当前系统实现。新抓取与分析流程从下方 Perfetto 系列开始。
随着 Systrace 的功能越来越完善,加上 Android 版本的更迭,之前写的 Systrace 系列教程已经有点过时;另外随着自己技能的完善,从 Systrace 里挖掘了更多的信息,对解决各种性能问题很有帮助。这些技能我需要记录下来,增强自己的总结和归纳的能力,如果能帮助到看文章的人,也是极好的
本系列的目的是通过 Systrace 这个工具,从另外一个角度来看待 Android 系统整体的运行,同时也从另外一个角度来对 Framework 进行学习。也许你看了很多讲 Framework 的文章,但是总是记不住代码,或者不清楚其运行的流程,也许从 Systrace 这个图形化的角度,你可以理解的更深入一些。
这篇文章记录了 Android 性能优化所必须掌握的知识(主要是对应的优秀文章、公众号、博客、技术团队等),涵盖性能优化相关的方方面面。本文会持续更新,欢迎各位自荐或者推荐。
Android 内存优化系列文章:
onTrimMemory(int level) 从 Android 4.0(API 14)提供,用于提示应用在合适的时机减少不必要的内存占用。合理缩减缓存有助于系统保留更多后台进程,但不能保证应用不被终止,也不能保证下次返回一定更快。
本文仍用问答方式介绍回调的作用、接入和资源清理。重点是按资源的用途决定保留什么、释放什么,并确保返回界面时能够恢复。
Android 内存优化系列文章:
我写这篇文章的初衷,是希望在动手写代码前,先把容易出内存问题的地方弄清楚,少留些问题到后面排查。下面从 Bitmap、数据库查询、列表复用和绘制等方面展开,看看资源由谁创建、谁持有、什么时候不再需要。这里有资源滞留、重复分配,也有泄漏,几种情况要分开处理。
Android 内存优化系列文章:
为了让垃圾回收器释放不再使用的对象,需要避免让长生命周期的对象继续持有已经无用的引用。判断条件是对象是否还能从 GC Roots 到达,并不是“有没有其他对象引用它”:一组互相引用、但整体不可达的对象也可以被回收。失去可达性不代表立即执行 GC,更不代表这部分内存立即归还给系统。
内存管理还包括缓存上限、资源所有权和组件生命周期。文件、连接和 native 资源应按各自接口及时关闭或释放,不能只等 Java 对象被 GC。
Android 内存优化系列文章:
这篇文章介绍的是 Android Java 代码中的微优化。选择合适的算法与数据结构仍应放在前面;减少热点路径上的重复工作和临时分配,才是这些技巧的主要用途。
本文最初整理自 Google Android Training 的 Performance Tips。标题中的“Java 官方篇”指这份 Android 文档里的 Java 代码建议,并非 Oracle 的 Java 性能规范。
系列文章目录:
技术复核(2026-10-13):本文保留 2015 年视频的三色柱形图。旧图的 Update / Execute / Process 可对照 Android 4.4.4 源码;Android 6.0 与 Android 16 已有更细的分段和不同参考线实现,不能把旧图例套到所有设备。
当时的视频简介:
“If you can measure it, you can optimize it” is a common term in the computing world, and for Android’s rendering system, the same thing holds true. In order to optimize your pipeline to be more efficient for rendering, you need a tool to give you feedback on where the current perf problems lie.
And in this video, +Colt McAnlis walks you through an on-device tool that’s built for this exact reason. “Profile GPU Rendering” will help you understand the stages of the rendering pipeline, and also get a chance to see what portions of it might be taking too long, and what you can do about it for your application.
Profile GPU Rendering 是开发者选项里的快速观察工具,可以帮助找到哪些操作伴随较高的绘制耗时。它的名字虽然有 GPU,柱形图却不是 GPU 硬件执行时间的直接测量,也不能单独告诉你卡顿的全部原因。官方说明
系列文章目录:
技术复核(2026-10-13):保留 2015 年的视频简介和九张示意图。正文已修正固定 60Hz、撕裂原因以及“VSync 复制后缓冲”的说法,并补充现代 Android 的帧率提示与分析入口。
当时的视频简介:
Unbeknown to most developers, there’s a simple hardware design that defines everything about how fast your application can draw things to the screen.
You may have heard the term VSYNC - VSYNC stands for vertical synchronization and it’s an event that happens every time your screen starts to refresh the content it wants to show you.
Effectively, VSYNC is the product of two components Refresh Rate (how fast the hardware can refresh the screen), and Frames Per Second (how fast the GPU can draw images), and in this video +Colt McAnlis walks through each of these topics, and discusses where VSYNC (and the 16ms rendering barrier) comes from, and why it’s critical to understand if you want a silky smooth application.
想要理解界面为什么流畅或卡顿,需要先区分应用产帧、系统合成和屏幕呈现。VSync(垂直同步) 用来协调这些阶段的节奏,不是刷新率与 FPS 的数学乘积,也不是一个替应用完成绘制的操作。AOSP VSync 说明
系列文章目录:
技术复核(2026-10-13):本文保留 2015 年的视频摘录和示意图。过度绘制的概念仍然适用;下文补充默认颜色表的版本依据、透明混合的例外和删除背景的前提,不把颜色变浅直接当成性能收益。
当时的视频简介:
One of the most problematic performance problems on Android is the easiest to create; thankfully, it’s also easy to fix.
OVERDRAW is a term used to describe how many times a pixel has been re-drawn in a single frame of rendering. It’s a troublesome issue, because in most cases, pixels that are overdrawn do not end up contributing to the final rendered image. As such, it amounts to wasted work for your GPU and CPU.
Fixing overdraw has everything to do with using the available on-device tools, like Show GPU Overdraw, and then adjusting your view hierarchy in order to reduce areas where it may be occurring.
视频开头作者举了一个例子,说如果你是一个粉刷匠,你应该会知道,给墙壁粉刷是一件工作量非常大的工作,而且如果你需要重新粉刷一遍的话(比如对颜色不满意),那么第一次的粉刷就白干了. 同样的道理,如果一个不透明区域完全覆盖了前面画出的内容,前面的部分绘制就可能没有贡献。如果你想兼顾高性能和完美的设计,那么你的程序可能会出现一个性能问题:OverDraw!
Overdraw(过度绘制) 指同一帧里,同一个像素被重复绘制。例如下面重叠的卡片,不透明卡片下面被完全遮住的部分可能做了无用功;但不能把“发生重叠”一律视为浪费。半透明内容、阴影和抗锯齿边缘仍需要底下的颜色参与混合,直接删掉底层会改变画面。实际工作量也受裁剪和渲染器优化影响。官方概念说明
系列文章目录:
技术复核(2026-10-13):本文是 2015 年视频的学习笔记,Nexus 5 的例子和工具截图保留为历史材料。下方原视频简介中的 16ms 是 60Hz 的近似说法;正文已修正刷新、掉帧和调试工具的适用范围。
当时的视频简介:
Rendering performance is all about how fast you can draw your activity, and get it updated on the screen. Success here means your users feeling like your application is smooth and responsive, which means that you’ve got to get all your logic completed, and all your rendering done in 16ms or less, each and every frame. But that might be a bit more difficult than you think.
In this video, +Colt McAnlis takes a look at what “rendering performance” means to developers, alongside some of the most common pitfalls that are ran into; and let’s not forget the important stuff: the tools that help you track down, and fix these issues before they become large problems.
当你觉得自己开发了一个改变世界的应用的时候,你的用户可能并不会这么认为,他们认为你的应用又慢又卡,达不到他们所期望的那种顺滑,更谈不上改变这该死的世界了,回收站走你!等等!明明我这个应用在我的Nexus5上非常顺滑啊?你咋能说又慢又卡呢?如果你对Android的碎片化有一定了解的话,你就应该知道,很多低配置的手机并不像Nexus5那样有强大的处理器和GPU,以及没有被怎么污染的原生系统。
如果有大量的用户投诉说你的应用又卡又慢的时候,不要总是抱怨用户的低端手机,有时候问题就出在你的应用本身,可能涉及渲染、主线程阻塞等问题,需要先测量再定位。了解问题发生的根源,才能有效地解决问题。所以了解Android渲染相关的知识,是一个Android开发者必不可少的知识。
系列文章目录:
2015 年,Google 推出了关于 Android 性能优化的短视频系列 Android Performance Patterns,原播放列表在 YouTube。官方当年的配套课程介绍也记录了这个系列。
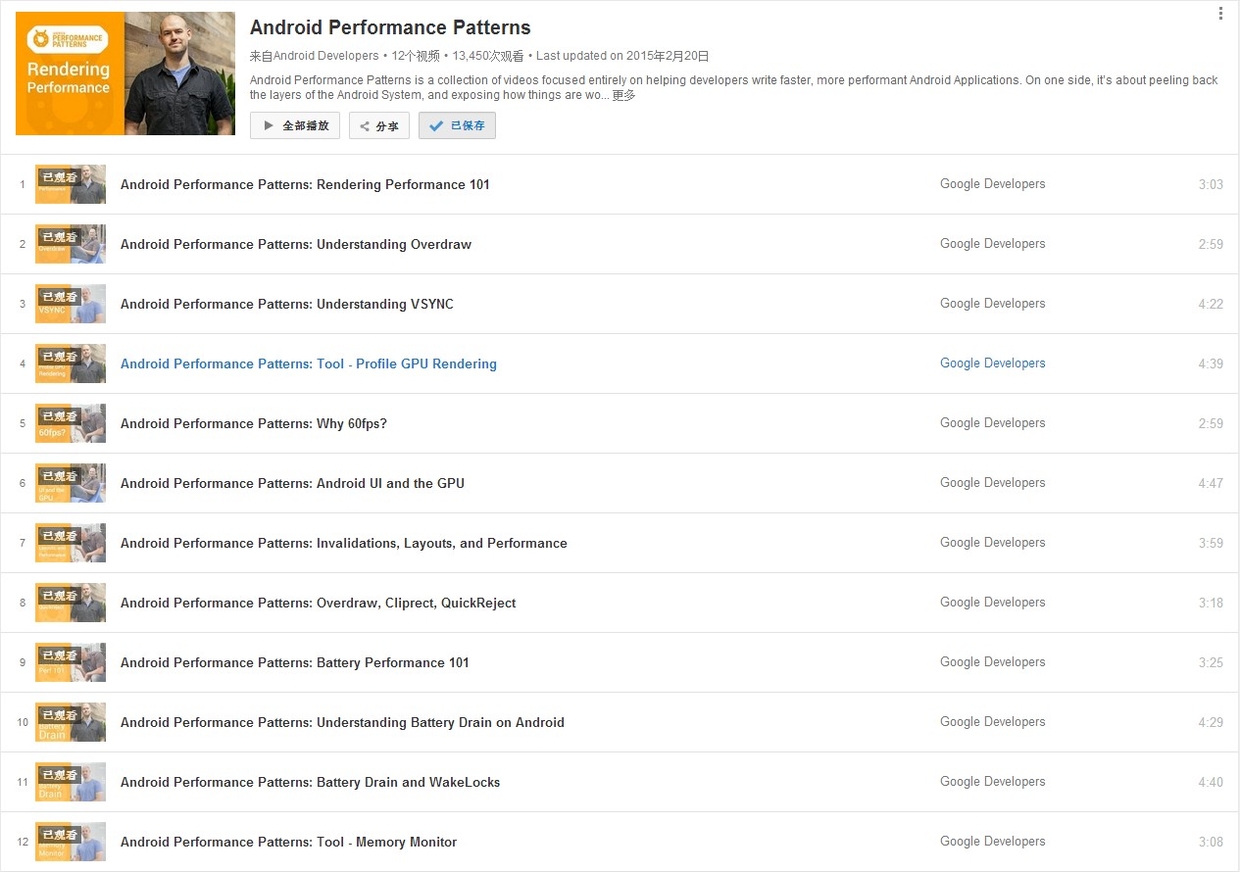
技术复核(2026-10-13):本文保留 2015 年的选题说明和观看经历。早期视频仍可用于理解渲染问题;旧工具、Google+ 入口及“16ms”说法需要按下面的版本条件阅读。
过度绘制、VSYNC、主线程与 RenderThread 的协作仍然值得学习,但帧间隔不是永远 16ms。60Hz 对应约 16.67ms,90Hz 约 11.11ms,120Hz 约 8.33ms;实际产帧截止时间还要看系统调度和 trace,不能把一个固定阈值套到所有设备与场景。
| 要调查的问题 | 今天的入口与适用条件 |
|---|---|
| View / Compose 的层级和属性 | 用 Layout Inspector 检查可调试应用;它也支持 Compose 重组/跳过信息,不能把层级检查等同于帧耗时测量 |
| 快速观察绘制阶段和过度绘制 | 开发者选项里的 Profile GPU/HWUI Rendering、Debug GPU Overdraw;柱形图是 CPU 侧绘制阶段信号,不是纯 GPU 执行时间,也不能覆盖所有自建渲染路径。官方说明 |
| 具体哪些帧错过期限 | 使用 Perfetto 的 FrameTimeline,要求 **Android 12 / API 31+**;再结合已采集到的线程、调度和 SurfaceFlinger 轨道定位 |
| 滑动或页面切换是否退化 | Macrobenchmark FrameTimingMetric 从 AndroidX Benchmark 1.1.0 提供;frameOverrunMs 要求 **API 31+**,与 frameDurationCpuMs 的口径不同 |
Hierarchy Viewer、Traceview 所属的旧 Android Device Monitor已在 Android Studio 3.1 弃用、3.2 移除。方法级分析使用当前 Profiler,层级检查用 Layout Inspector。做 Macrobenchmark 时按项目配置要求使用接近发布状态的 non-debuggable、profileable 目标应用,并固定设备与操作场景。
当时的官方简介(原文摘录):
Android Performance Patterns is a collection of videos focused entirely on helping developers write faster, more performant Android Applications. On one side, it’s about peeling back the layers of the Android System, and exposing how things are working under the hood. On the other side, it’s about teaching you how the tools work, and what to look for in order to extract the right perf out of your app.
But at the end of the day, Android Performance Patterns is all giving you the right resources, at the right time to help make the fastest, smoothest, most awesome experience for your users. And that’s the whole point, right?
总之就是一系列讲解Android性能相关的视频。这些小视频的时间非常短,在3-5分钟之内,主讲人的英文语速也非常快,初期这些视频没有翻译的时候,着实考验了一把听力。当时已有中英文字幕可供参考;现在具体有哪些字幕,以各视频实际提供的轨道为准。
这些视频的时间虽然很短,但是信息量却非常大,有些他一句话带过的内容,我们却需要花费很多的时间去研究他的原理,或者研究一个调试工具如何使用。也就是说,这一系列视频并没有真正教你如何去优化你的应用,而是告诉你关于Android性能优化你需要知道的知识,这样你去优化你的Android应用的时候,知道该用什么工具,该采取什么样的步骤,需要达到什么样的目标。
本文是 MAT 工具使用系列的第三篇,这个系列共三篇,详细介绍了如何使用 MAT 来分析内存问题,既可以是 Java 应用的内存问题,也可以是 Android 应用的内存问题:
技术复核(2026-10-13):这是依赖旧 Bitmap 实现的历史技巧,保留原截图。下文以 AOSP android-4.4.4_r2 核对
mBuffer,以 Android 8.0 / API 26 说明 native 像素的变化,并补充 GIMP 3.2.6 导入参数及现代调试入口。
在 MAT 里查图片相关的内存问题时,如果能知道“到底是哪张图”,排查起来会方便很多。这里的“原图”指 Bitmap 在运行时保存的像素,不能恢复下载前的 JPEG/PNG 文件、压缩参数或 EXIF。MAT 能帮我们找到是谁留着这个对象,再把图像和业务场景对应起来;单凭一个 Bitmap 很大,还不能判断它泄漏了。
本文介绍从旧 heap dump 导出像素的步骤。前提是快照确实包含像素数组;只有 Java 包装对象和 native 地址时,不能从不存在的数据还原图片。
本文是 MAT 工具使用系列的第二篇,这个系列共三篇,详细介绍了如何使用 MAT 来分析内存问题,既可以是 Java 应用的内存问题,也可以是 Android 应用的内存问题:
技术复核(2026-10-13):保留 2015 年的操作截图,概念与菜单说明对照 MAT 1.17.0 文档。旧 Android Studio 的右键转换和 GC 按钮不代表当前界面;下文修正引用方向、Unreachable 和泄漏判定,并补上缺失的分析步骤。
抓取流程见本系列入门篇:先在 Android Studio Profiler 以 debuggable / complete data 模式获取 heap dump,再按需要导出给 MAT。自动化测试可使用 LeakCanary,但普通 leakcanary-android 依赖应放在 debug 构建;官方 2.14 文档里的 release 分析方案仍标为实验性质,不能把“接入 LeakCanary”直接当成通用线上采集方案。UI 测试集成 / release 方案
下面是早期 Android Studio 的抓取界面,保留作为历史记录:
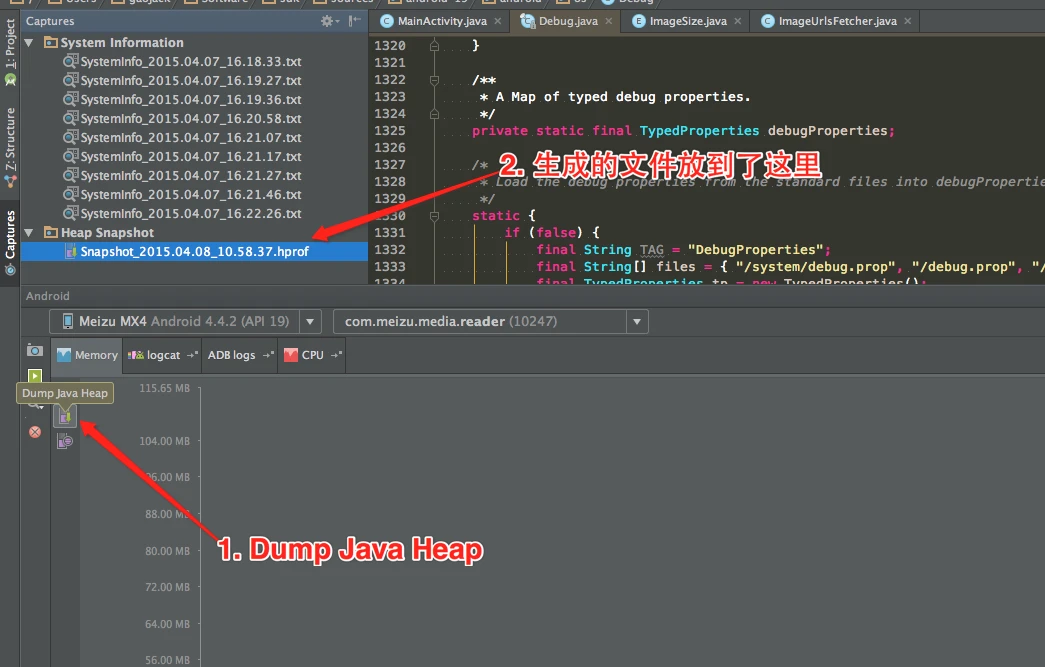
本文是 MAT 工具使用系列的第一篇,这个系列共三篇,详细介绍了如何使用 MAT 来分析内存问题,既可以是 Java 应用的内存问题,也可以是 Android 应用的内存问题:
技术复核(2026-10-13):本文保留原教程和历史截图。MAT 的堆分析概念仍适用;旧 Eclipse/DDMS 抓取流程已过期。下载与运行要求更新到 MAT 1.17.0(2026-06-10,独立版要求 Java 21+),并修正 ART、Bitmap、Retained Size 和引用类型说明。
现在可以先在 Android Studio Profiler 抓取 Java/Kotlin heap dump,再按需要导出给 MAT 分析。Android 内存泄漏也可用 LeakCanary 辅助定位。MAT 主要回答托管堆中的对象为何仍被保留;进程总内存和 native 分配还要结合 dumpsys meminfo、native allocation recording 或 Android 10+ 的 Perfetto heapprofd。后者在 user 系统上要求应用允许 debuggable 或 profileable,不能任意采集其他应用。
MAT(Memory Analyzer Tool),一个基于 Eclipse 的内存分析工具,是一个快速、功能丰富的JAVA heap分析工具,它可以帮助我们查找内存泄漏和减少内存消耗。使用内存分析工具从众多的对象中进行分析,快速的计算出在内存中对象的占用大小,看看是谁阻止了垃圾收集器的回收工作,并可以通过报表直观的查看到可能造成这种结果的对象。
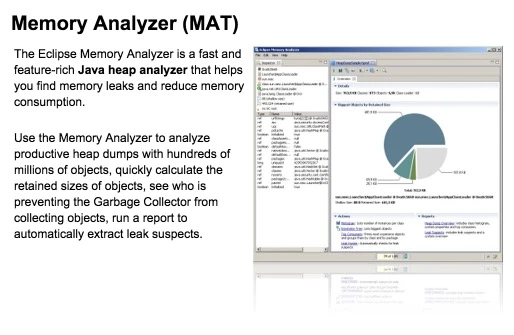
MAT 有 Eclipse 插件和独立的 Eclipse RCP 应用。独立版不要求先安装完整 Eclipse IDE,但仍需要兼容的 Java 运行环境。Android HPROF 是否需要转换,取决于导出格式和分析器支持,不取决于 MAT 是插件还是独立安装。
本文是一篇译文,原文Android Performance Case Study Follow-up的作者是大名鼎鼎的Romain Guy。本文讲述了Android性能优化的一些技巧、方法和工具。
技术复核(2026-10-13):保留 2015 年 Falcon Pro 3 / Moto X 2014 的历史案例,以下第一人称属于原作者。Tracer for OpenGL ES、Hierarchy Viewer 所在的 Android Device Monitor 已在 Android Studio 3.1 弃用、3.2 移除;旧工具步骤标为历史内容,文末补充 Android 12+ 的 Perfetto 分析入口。原站链接本次未能重新读取,技术修订依据文中列出的官方资料和版本化源码。
两年前,我发表了一篇名为Android Performance Case Study 的文章,来帮助Android开发者了解需要使用什么工具和技术手段来确定、追踪和优化性能问题。
那篇文章以一个Twitter客户端 Falcon Pro为典范,其开发人员为 Joaquim Vergès. Joaquim人不错,他允许我在我的文章中使用它的程序作为例子,并且快速处理了我发现的所有问题。一切都OK,直到Joaquim 从头开始开发Falcon Pro 3,前不久在他准备发布它的新应用的时候,他联系了我,因为他有一个和滚动相关的性能问题需要我来帮助他,这一次我依然没有源代码可以参考。
上一篇文章从理论的角度讲解了一下什么是过度绘制,以及可以用来查看和确认过度绘制的工具,还提供了一些优化过度绘制的方法。对代码和布局比较熟悉的人,看完上一篇其实就已经可以对自己的应用进行优化了。我记得有人说过,用iphone你只需要保证苹果有节操即可,用Android你就得保证所有的Android开发者都有节操。但现实是残酷的,现在Android市场上,有很多粗制滥造的应用,其中不乏大厂之作,各位打开过度绘制按钮,就知道我所言非虚。作为一个Android开发人员,我肯定是更希望Android能一步一步好起来,超越iphone。
这篇文章从实战的角度,讲解了一个过度绘制的优化过程。当然这里用到的只是很少的一部分,毕竟每个应用差别很大,优化方式也各不一样。所以这篇文章仅供参考,想把这块做好还是要下功夫的。
如果没有看过前一篇,可以点这里:Android性能优化之过度绘制(一)
2026-10-13 更新:本文原写于 2014 年,源码节选已对照 AOSP
android-4.4.4_r2。Overdraw 的概念仍适用,ADT、monitor、Hierarchy Viewer 和旧 OpenGL 跟踪入口已过时;Android Studio 3.1 起改用 Layout Inspector 查看层级,帧时序使用 Perfetto。下文保留历史源码,并补充 Android 12 / Android 16 的对应边界。
博客有一段时间没有更新了,到了新公司后,一直比较忙,博客也更新地不那么频繁了。最近一直在看Android上和性能相关的部分,也就是所谓的Android性能优化,才发现Android性能这一块,自己懂得还是太少了,所以从上层开始看,也算是一点一点入门吧。这个系列将讲解学习过程中总结的和性能相关的内容。
先讲讲 GPU 过度绘制,也是开发者最直接接触的部分吧。这个内容分两篇来讲:第一篇讲原理和一些优化建议,第二篇用实际例子来看一般的优化步骤。
GPU 过度绘制(Overdraw)指同一帧内,一个像素被绘制多次。例如 TextView 先画背景再画文字,文字覆盖到的像素就可能参与两次绘制。多余的像素着色、混合和内存访问会消耗资源,但是否造成掉帧,取决于绘制面积、透明度、GPU 能力以及这一帧的其他工作,不能仅凭颜色数量判断。Android 过度绘制说明